STRATÉGIE & VALIDATION · FUTURES
Behind the EdgeTa stratégie de trading fonctionne-t-elle vraiment ?
Évaluer une méthode de trading : coûts, incertitude et tests sans connaître la suite.
Huit graphiques pédagogiques en anglais, accompagnés de légendes en français. Tous les exemples sont hypothétiques ou simulés.
Tu termines le mois en profit. Tes entrées semblent propres. Tes meilleurs trades paraissent confirmer tout ce que tu crois comprendre du marché.
Quelle part de ce résultat peux-tu raisonnablement espérer reproduire ?
Cette question relie les précédents articles de la série. Behind the Candles expliquait comment les prix des futures évoluent et comment les ordres deviennent des exécutions. Behind the Risk explorait ce que ces exécutions peuvent faire à un compte. Cet article examine les éléments qui permettent d’évaluer les décisions elles-mêmes.
Un beau graphique peut être le point de départ d’une recherche. La confiance doit venir de la manière dont une méthode a été définie et testée, de ce que ses résultats incluent, et de ce qui se passe lorsqu’elle rencontre des informations qu’elle n’a jamais vues.
Les exemples qui suivent concernent l’évaluation de méthodes de trading sur futures, notamment les décisions intraday d’un trader sur le NQ ou le GC. Chaque exemple chiffré et chaque graphique est hypothétique ou simulé. Aucun ne représente mon historique de trading, une prévision de marché ou une stratégie dont la rentabilité aurait été vérifiée.
L’article en deux minutes
- Définis la décision avant de mesurer le résultat. Un setup a besoin de règles claires d’entrée, de sortie, de contexte et d’exclusion.
- Utilise des résultats nets. Les frais, les ordres non exécutés et les écarts d’exécution peuvent absorber un petit avantage apparent.
- Un échantillon contient de l’incertitude. Plus de trades aident, mais répéter une exposition à une seule condition de marché apporte des éléments limités.
- Conserve chaque version essayée. Le meilleur résultat d’une longue recherche peut être un résultat chanceux.
- Préserve les informations réellement nouvelles. Dès que tu utilises un résultat de test pour améliorer les règles, ce test fait partie du développement.
- Sépare le processus du résultat. Une violation des règles profitable et une perte prévue n’enseignent pas la même chose.
- Accepte que les éléments restent incomplets. « Prometteur, mais pas établi » est une conclusion utile.
1 Ce que signifie réellement un avantage en trading
À retenir
Un avantage, ou « edge », correspond à une espérance de résultat favorable après coûts, dans des conditions précisées. Un échantillon profitable est un élément à examiner, pas une mesure directe de ce que l’avenir te doit.
Imagine répéter une décision de nombreuses fois dans des situations comparables. Certaines tentatives gagnent, d’autres perdent, et les montants diffèrent. Avoir un avantage signifierait que le résultat net moyen de cette décision est positif dans ces conditions. La présentation pédagogique de l’espérance mathématique par CME relie les deux composantes essentielles : la fréquence des résultats et leur montant. [1]
Une espérance n’est pas une garantie. Elle ne signifie pas non plus qu’un trader doit gagner un montant fixe chaque jour. L’espérance est une propriété d’un processus sous certaines hypothèses ; le résultat est ce qui s’est produit dans une séquence particulière.
Trois choses méritent donc des noms distincts :
- Une idée : « Une cassure pourrait se prolonger lorsque la participation augmente. »
- Une méthode : les règles qui déterminent quelle cassure est admissible, quand entrer, comment sortir et quand s’abstenir.
- Des éléments de validation : les observations recueillies lorsque ces règles sont appliquées, y compris les trades perdants et les séances qui dérangent.
Une explication peut sembler convaincante sans produire de trades rentables. Une configuration peut aussi sembler profitable sur un petit échantillon sans explication convaincante. Les deux situations méritent d’être étudiées.
Une raison plausible derrière une configuration est utile : elle suggère quoi mesurer et dans quelles circonstances la configuration pourrait échouer. Elle ne remplace pas un test. « Les acheteurs étaient agressifs » est une description ; savoir si une entrée précise après cette observation produit des résultats nets intéressants reste une autre question.
Pour faciliter la lecture, cet article utilise R comme unité de risque de prix initial prévu. Si ce montant est de 100 $, un gain net de 150 $ correspond à +1,5R. Garde ce dénominateur initial fixe pour le trade, même si le stop se déplace. Un stop ne garantit pas une perte maximale, et une perte réalisée peut dépasser 1R. L’article sur le risque détaille ces mécanismes.
2 Transformer un setup en quelque chose de testable
À retenir
Quelqu’un doit pouvoir comprendre pourquoi un trade était admissible à partir des seules informations disponibles avant l’entrée.
« Je prends les cassures fortes » laisse plusieurs décisions indéfinies. Fortes à quel point ? Au-dessus de quel niveau ? À quelle heure ? Qu’est-ce qui invalide une cassure ? Ces zones floues permettent de reconnaître les gagnants après coup et d’écarter discrètement les exemples perdants.
Voici une fiche de règles de recherche volontairement simple, avec le NQ comme exemple. Ces paramètres sont des choix pédagogiques arbitraires, pas ma stratégie personnelle ni des recommandations de trading.
- Marché et données : un contrat NQ précisément identifié, des bougies classiques d’une minute, l’heure locale de New York avec une gestion correcte des changements d’heure. Note le flux de données et la règle de sélection du contrat.
- Référence : le plus haut prix échangé entre 09:30:00 et 09:44:59 inclus.
- Déclenchement : la première bougie complète d’une minute, après cette période de référence, qui clôture au-dessus du plus haut de cette période. Le signal doit être confirmé avant 10:30.
- Entrée : un achat au marché simulé au prochain tick disponible après la confirmation. Ne suppose pas implicitement une exécution au prix de clôture de la bougie du signal.
- Sortie : un stop 20 points sous l’entrée enregistrée et un objectif 40 points au-dessus. Ferme toute position restante à 11:00. Au maximum un trade par séance, sans renfort ni sortie partielle dans cette version de recherche.
- Exclusions : avant le test, identifie les séances entières à exclure en raison des dates prévues de publication du CPI, du rapport américain sur l’emploi ou des décisions du FOMC. Consigne séparément les séances dont les données sont manquantes. Conserve la liste des séances exclues et le motif de chaque exclusion.
Pour la mise en œuvre, documente les coûts, les exécutions, les gaps et les événements simultanés. La section 7 explique comment ces choix peuvent modifier un test.
Cet exemple est délibérément restreint. Un résultat profitable s’appliquerait à cette version, à ses données et aux conditions testées. Il ne démontrerait pas que toutes les cassures sur le NQ fonctionnent, que les entrées vendeuses se comportent de la même manière ou que ces règles se transposent à l’or.
Le trading discrétionnaire peut lui aussi être évalué. Enregistre une capture et une courte explication avant de connaître le résultat. Utilise une checklist courte et stable pour tes appréciations. Si une « structure propre » compte, décris les caractéristiques visibles qui la définissent et conserve les cas limites. Revoir des graphiques en masquant les bougies futures aide à déterminer si tes classifications sont reproductibles.
L’objectif est de rendre la décision vérifiable. Changer ton interprétation après avoir vu la sortie revient à changer l’expérience.
3 Mesurer ce qui arrive réellement sur le compte
À retenir
Une méthode doit résister à l’écart entre des prix théoriques attrayants et des résultats nets réellement exécutables.
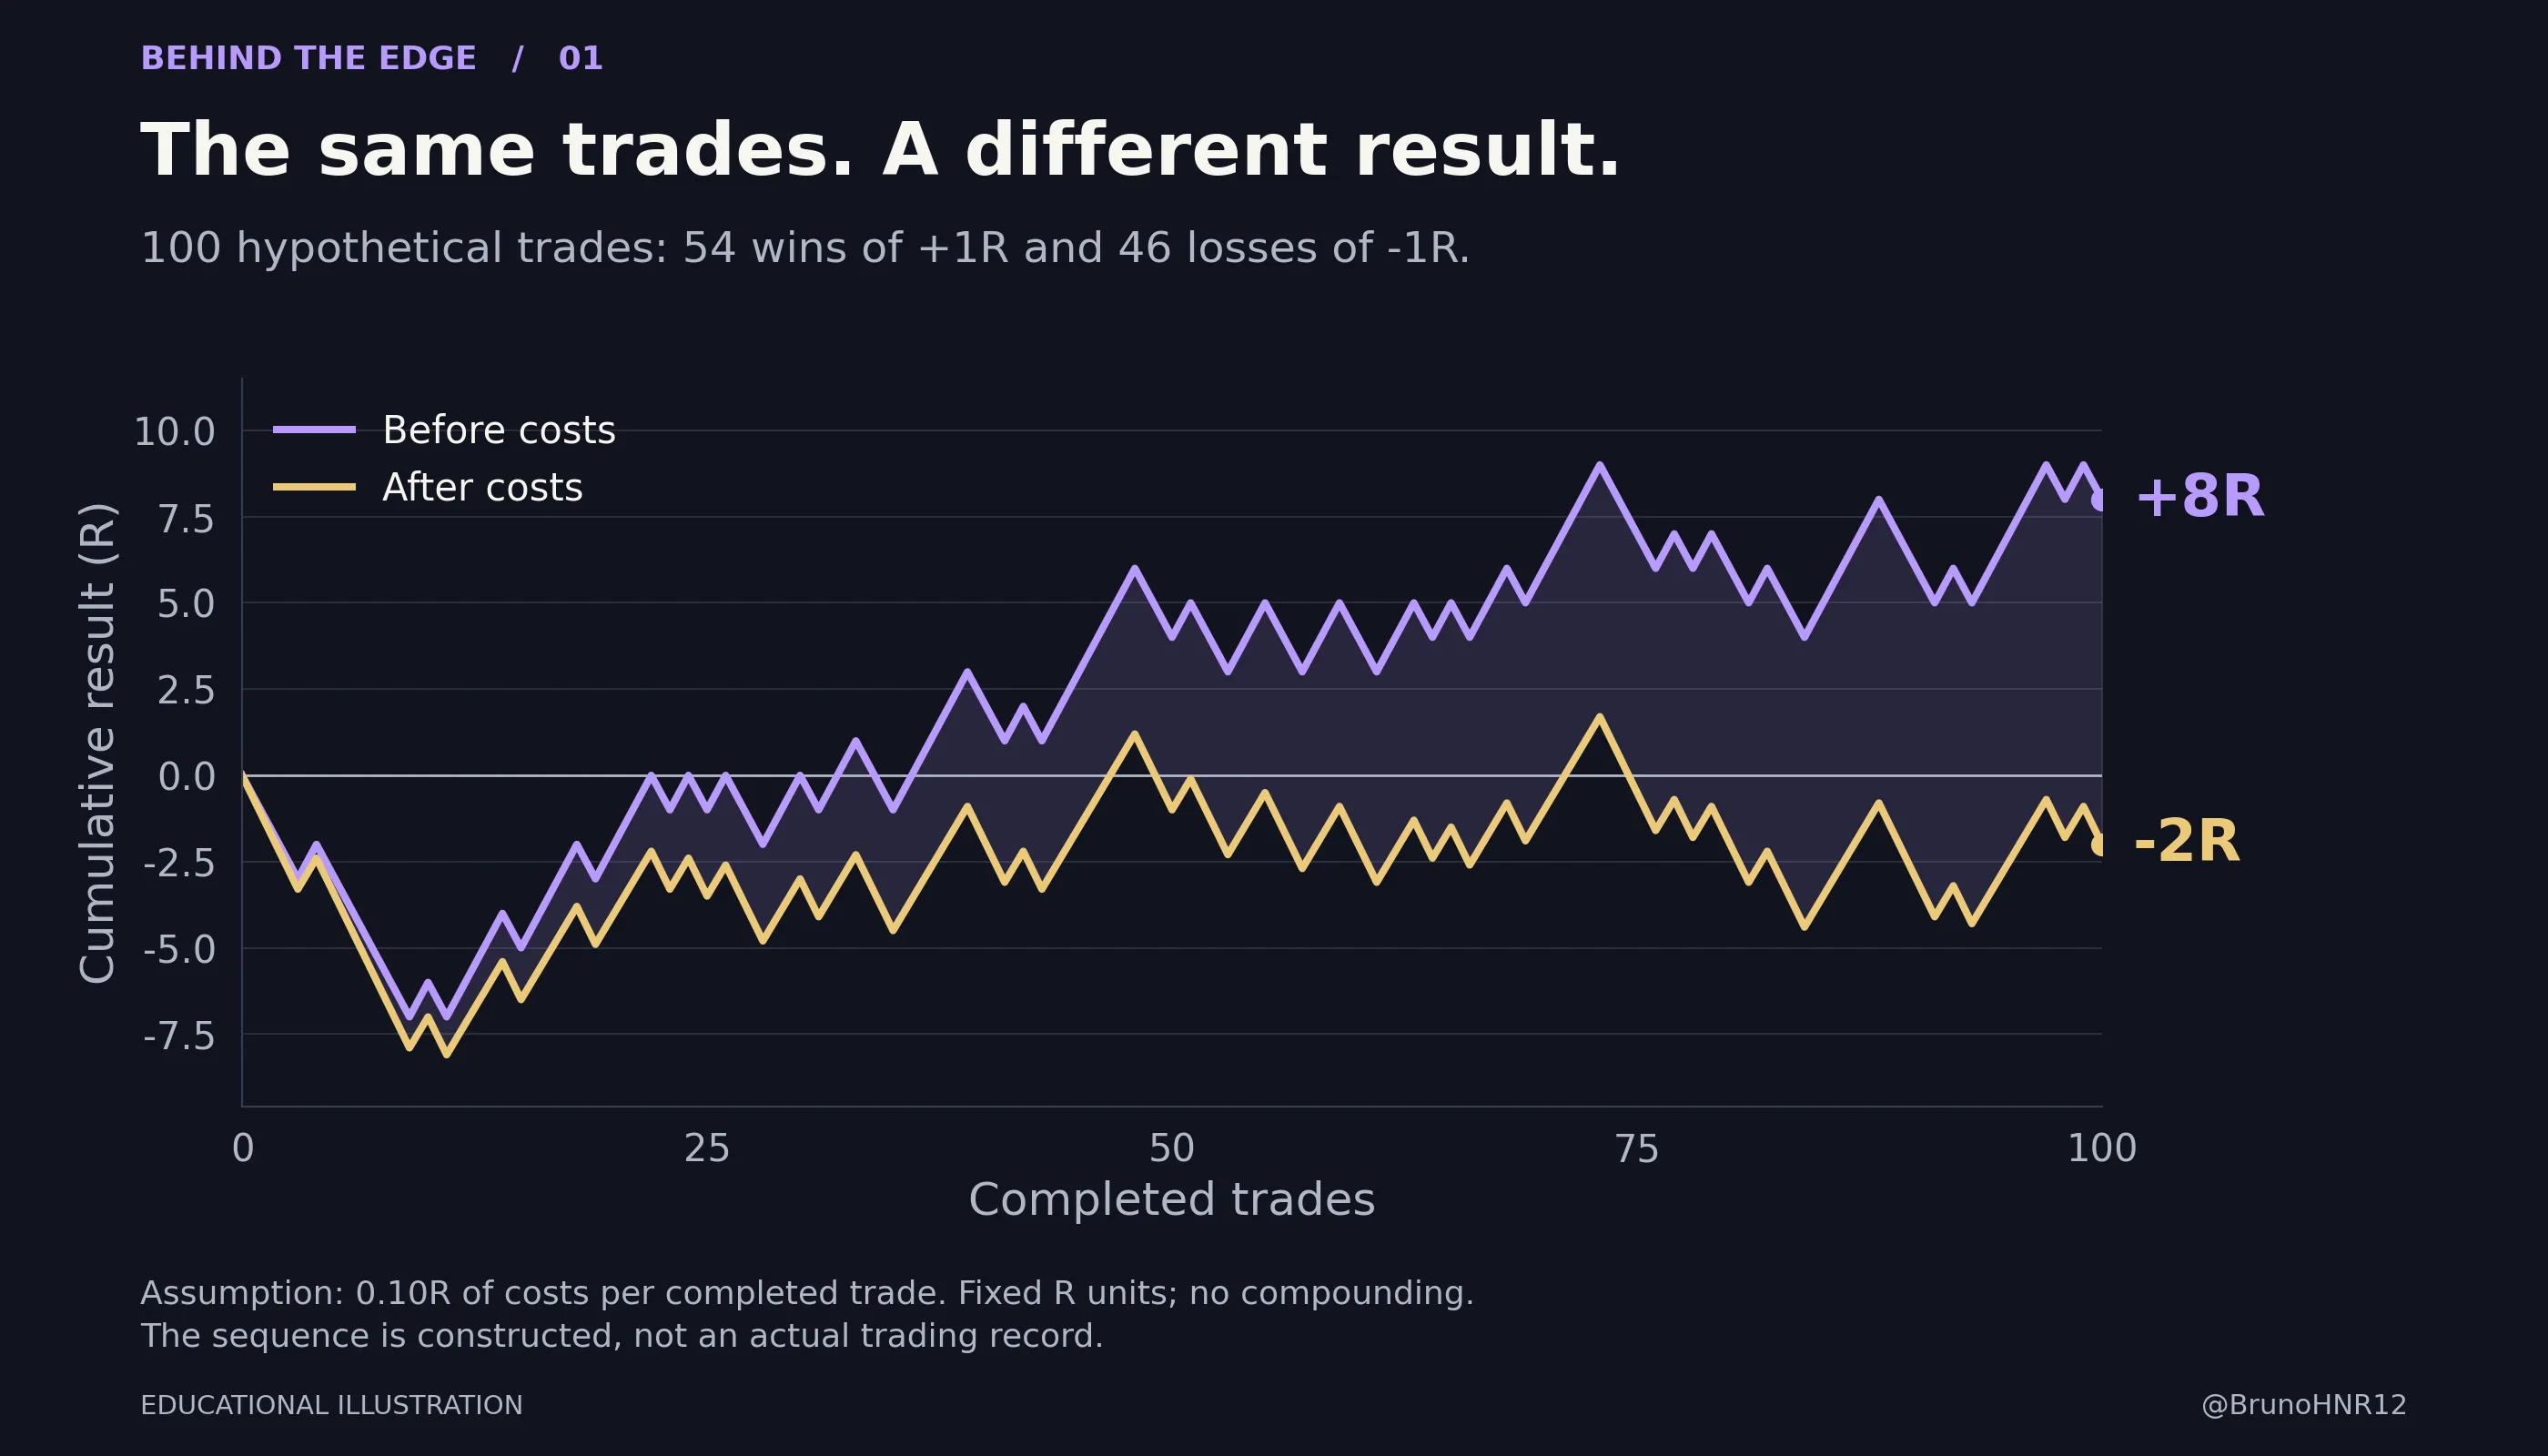
Prenons 100 trades hypothétiques : 54 gagnants à +1R et 46 perdants à −1R. Leur total brut est de +8R. Supposons un coût combiné de 0,10R par trade terminé. Le coût total atteint 10R, ce qui laisse −2R nets, soit −0,02R par trade.
La courbe brute de la figure 1 termine au-dessus de zéro. La courbe nette utilise exactement les mêmes résultats de trades et termine en dessous.
Ce coût supposé est une illustration, pas le tarif d’un broker. Pour donner un ordre de grandeur, un MNQ vaut 2 $ par point d’indice. Une distance initiale de risque de prix de 25 points représente donc 50 $ par contrat ; des frictions hypothétiques combinées de 5 $ pour l’aller-retour représenteraient 0,10R. Les frais réels et les écarts d’exécution dépendent du produit, de l’ordre, du broker et des conditions. [2]
Pour un backtest fondé sur des prix de signal idéaux, modélise les commissions et les frais ainsi qu’une hypothèse d’exécution adaptée. Pour un journal fondé sur les prix d’entrée et de sortie réellement exécutés, le franchissement du spread et le slippage figurent déjà dans ces prix. Soustrais les frais explicites applicables sans déduire deux fois le même effet d’exécution.
Rapproche également le journal des relevés du compte. Les exécutions partielles, sorties multiples et renforts doivent suivre une définition cohérente du trade. Diviser une position en cinq sorties ne crée pas cinq décisions de trading indépendantes.
Garde les dépenses fixes de l’activité, comme les abonnements aux données, visibles dans un rapprochement distinct avec le résultat global de l’activité. Une méthode peut être positive après coûts variables de trading sans couvrir ces frais fixes à ta fréquence de trading.
Enfin, compare des éléments comparables. Si le nombre de contrats change, une courbe en dollars qui monte peut refléter en partie une exposition plus importante. Suis les résultats nets en R avec les résultats en dollars et la taille des positions. La série en R nécessite elle aussi des définitions cohérentes et ne décrit pas, à elle seule, le risque au niveau du compte.
4 Comprendre l’incertitude d’un échantillon
À retenir
Aucun nombre universel de trades ne prouve un avantage. La taille de l’échantillon compte, avec sa variabilité, sa dépendance, les conditions de marché couvertes et l’ampleur des recherches effectuées.
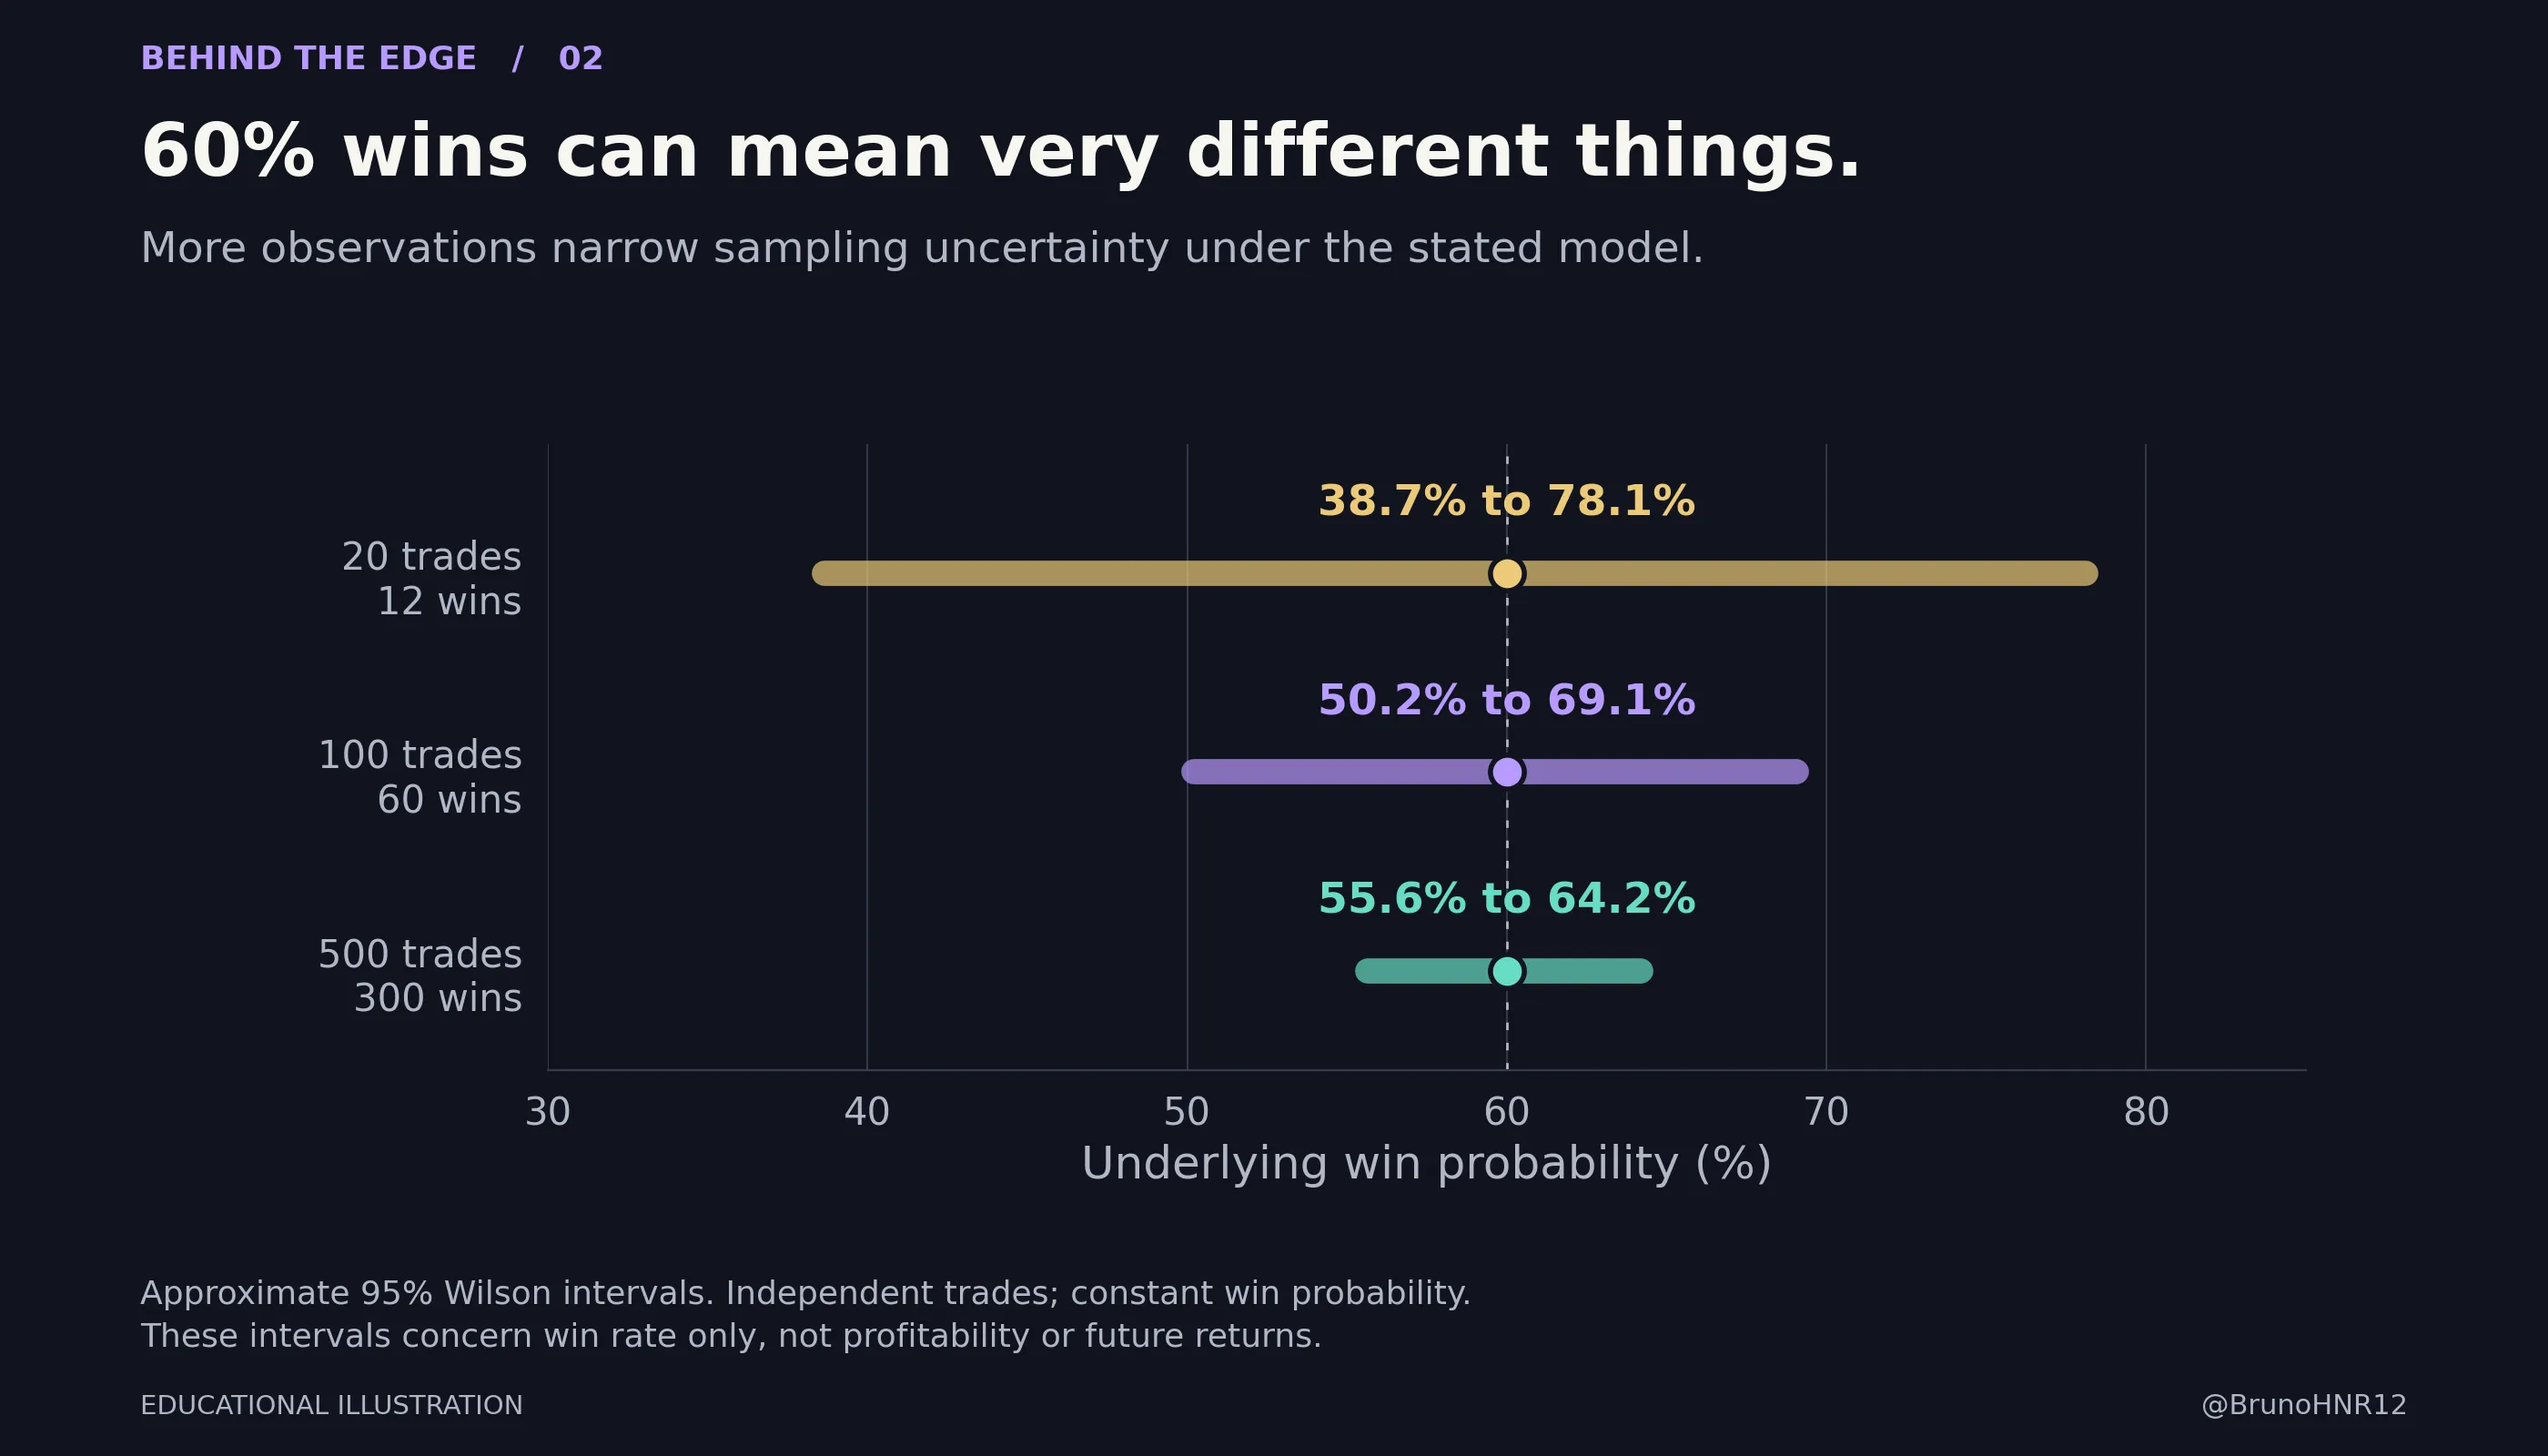
Supposons trois historiques affichant tous 60 % de trades gagnants : 12 gains sur 20 trades, 60 sur 100 et 300 sur 500. Le pourcentage mis en avant est identique. Sa précision ne l’est pas.
La figure 2 utilise des intervalles de confiance de Wilson approximatifs à 95 % pour ces décomptes hypothétiques. Dans un modèle de trades indépendants ayant la même probabilité sous-jacente de gain, les intervalles sont d’environ 38,7 % à 78,1 %, 50,2 % à 69,1 % et 55,6 % à 64,2 %. [3]
Un intervalle de confiance exprime l’incertitude d’une estimation. La mention 95 % décrit la couverture de la procédure à long terme, sous ses hypothèses. Elle ne signifie pas que cette stratégie précise a 95 % de chances de gagner de l’argent. [4]
Et le taux de réussite n’est qu’un ingrédient. Ces intervalles ne disent rien de la taille des gains, de celle des pertes ni des coûts du trading. Un intervalle étroit autour d’une structure de gains et de pertes non rentable ne résout rien.
Les hypothèses méritent aussi de l’attention. Plusieurs entrées durant une même tendance peuvent partager le même épisode de marché. Dix comptes qui copient un trade produisent dix enregistrements comptables, mais une seule décision indépendante. Des positions NQ et MNQ prises sur le même signal sont des observations étroitement liées, pas une multiplication gratuite des éléments de validation.
Les méthodes statistiques supposant des observations indépendantes peuvent mal évaluer l’incertitude lorsque les résultats sont dépendants. Le NIST explique pourquoi il faut examiner la dépendance temporelle avant d’appliquer des formules statistiques courantes. [5]
Pour une revue pratique, compte les trades et les séances, indique la période calendaire et regarde si les résultats se concentrent autour de quelques événements. Une analyse plus avancée peut regrouper les observations par séance ou utiliser un rééchantillonnage par blocs adapté pour préserver une partie de la dépendance. Aucune de ces techniques ne peut fournir des conditions de marché absentes des données d’origine.
Si une stratégie comporte de très rares gros gagnants, des coûts très variables ou des conditions changeantes, estimer son résultat net moyen peut exiger bien plus d’éléments que son taux de réussite ne le suggère. Une échéance calendaire ou un chiffre rond comme 100 trades ne résout pas automatiquement cette incertitude.
5 Regarder à l’intérieur du profit total
À retenir
Demande-toi quels trades et quelles conditions ont produit le résultat. La concentration du profit est à comprendre, pas à effacer de l’historique.
Un journal hypothétique termine à +15R après 100 trades. Cela semble simple, jusqu’à ce que tu découvres que les trois plus gros gagnants ont apporté +20R, tandis que les 97 autres trades ont produit −5R.
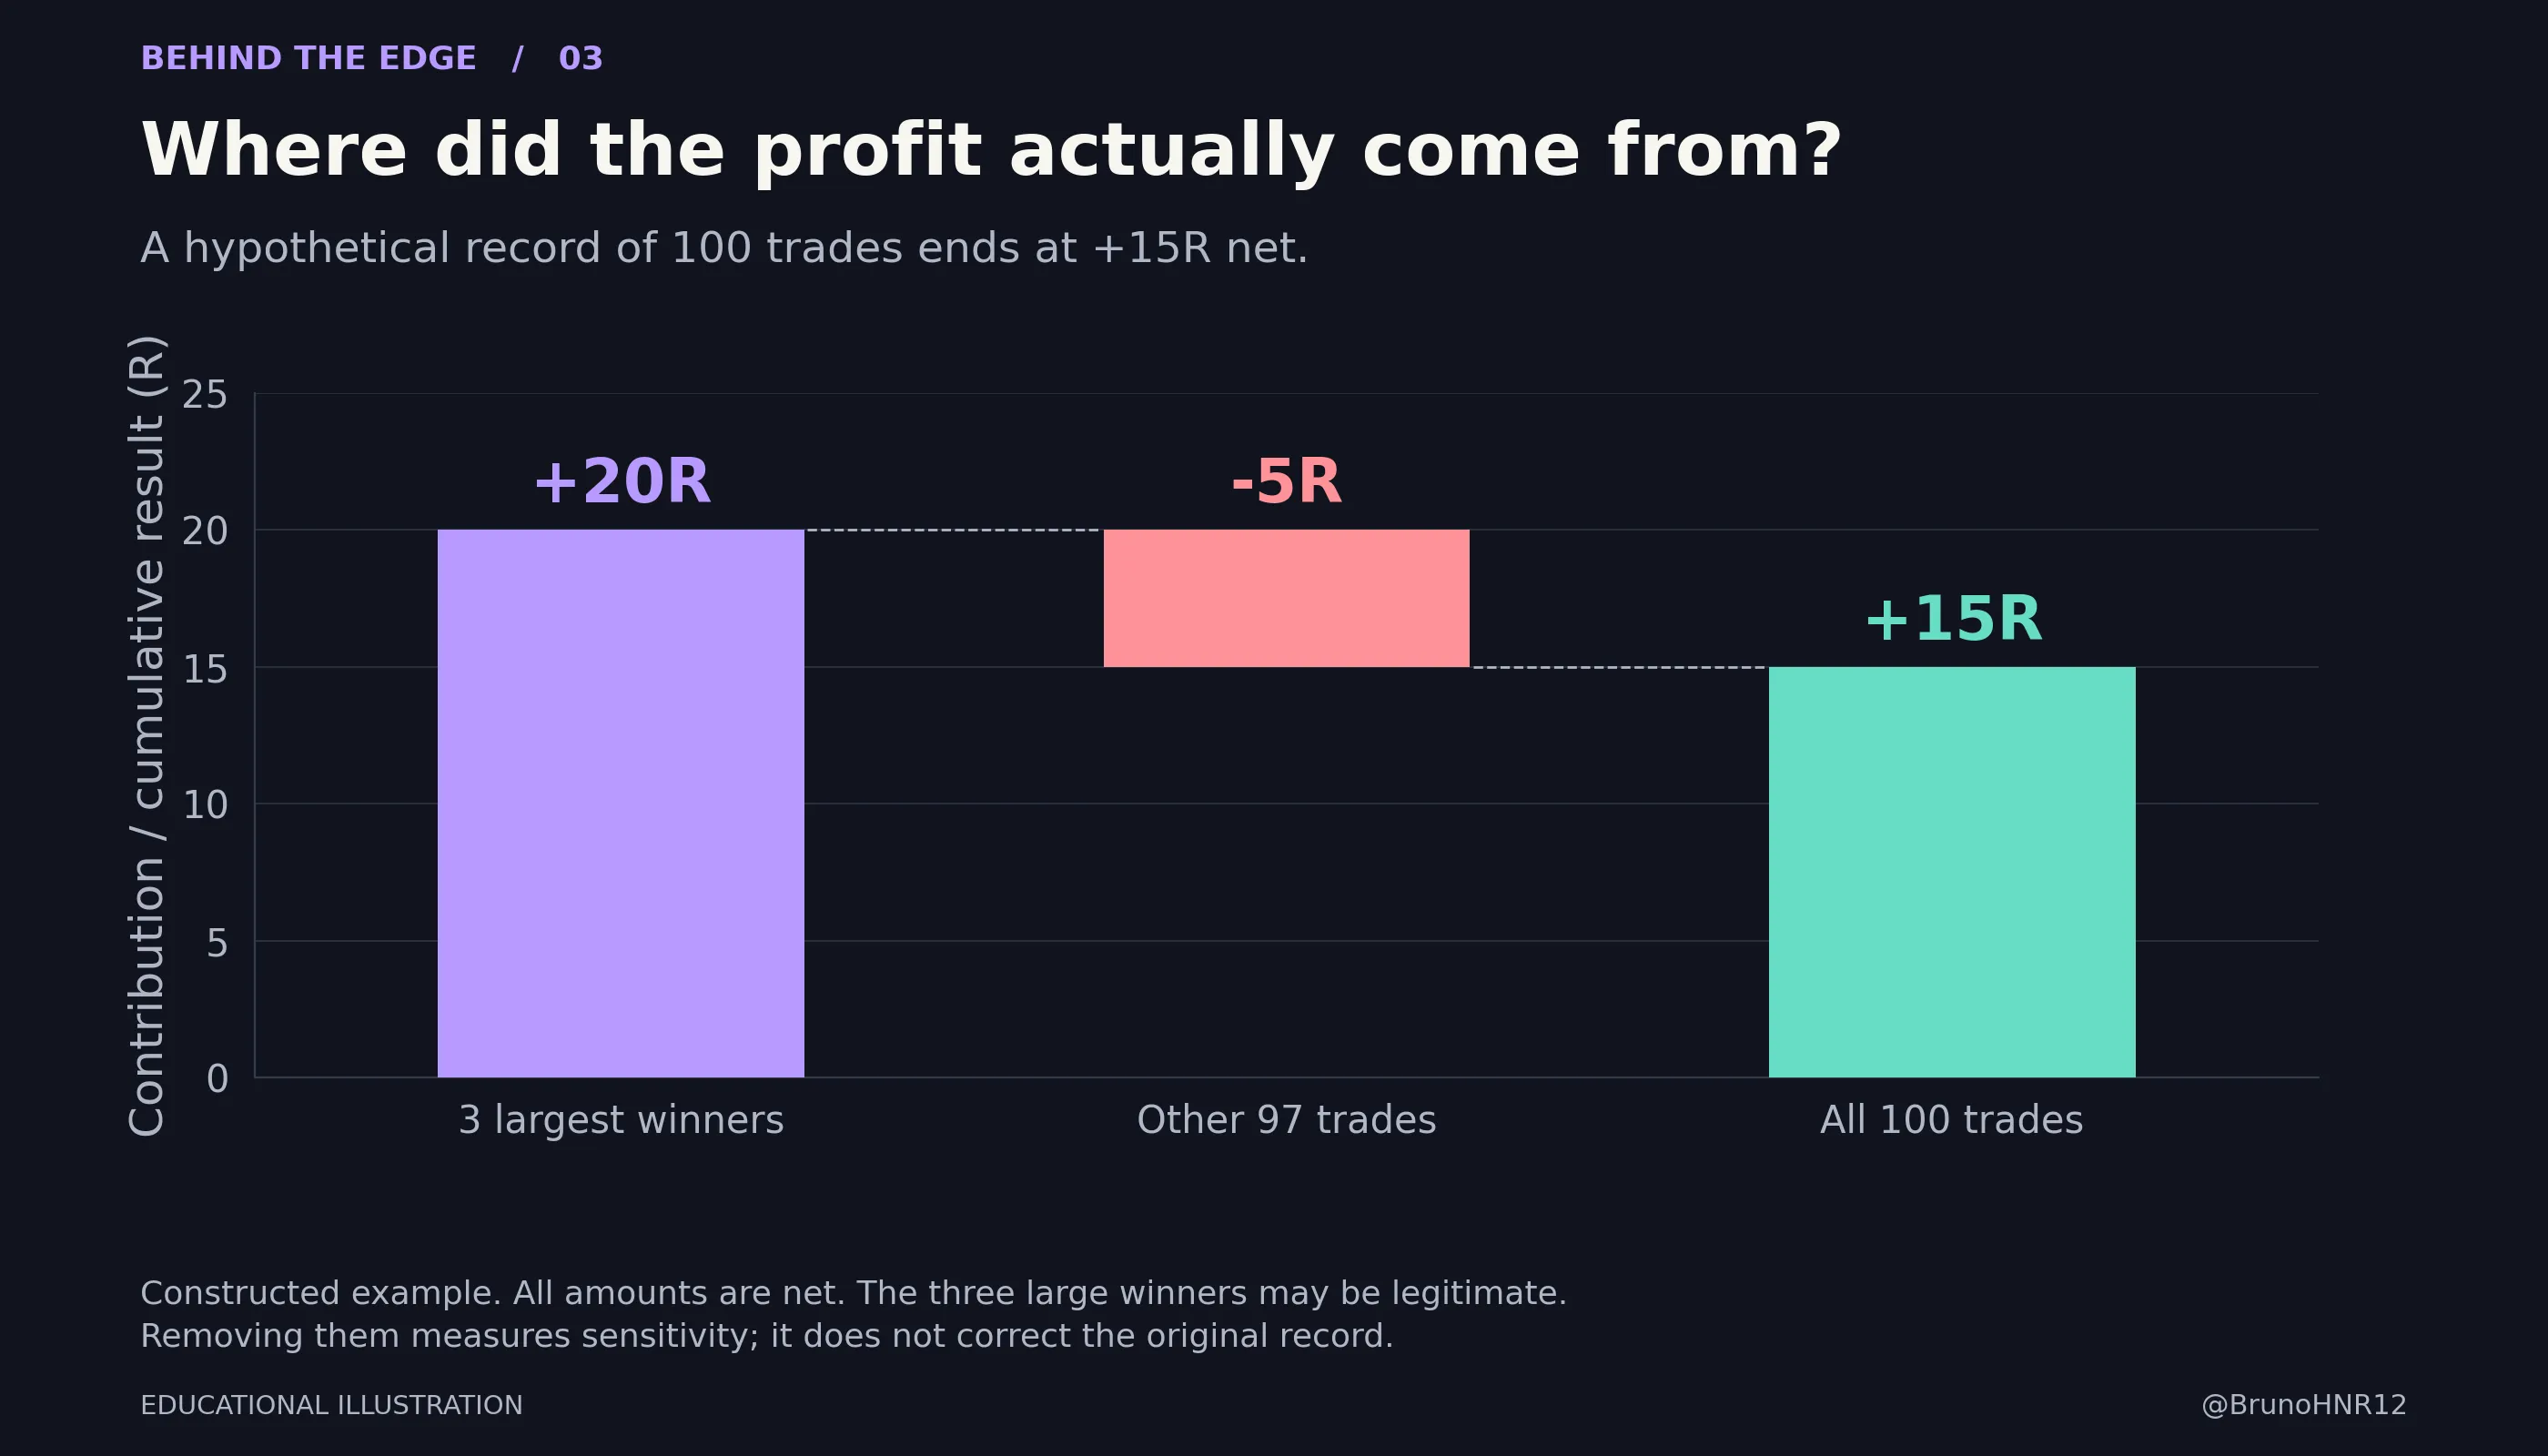
Cette répartition ne rend pas automatiquement une stratégie mauvaise. Une méthode conçue pour capter occasionnellement de grands mouvements peut naturellement dépendre d’un petit nombre de gros gains. Les supprimer retirerait une partie du comportement recherché par la méthode.
Les questions utiles sont plus précises. Ces gagnants respectaient-ils les règles d’origine ? Les sorties auraient-elles été exécutables ? Se sont-ils produits durant des séances que tu refuses habituellement de trader ? Tes règles de gestion réelles t’auraient-elles permis de rester dans le mouvement ?
La distinction compte pour les traders qui évitent les annonces. Si presque tout le profit simulé vient de positions conservées pendant des publications que ton plan exclut, le test décrit une autre activité. Tu ne peux pas garder ce profit tout en revendiquant le bénéfice d’éviter ces périodes.
Examine la performance selon quelques catégories pertinentes choisies avant l’évaluation : achat contre vente, séance, condition de volatilité ou version du setup. Indique le nombre d’observations et le résultat net total de chaque catégorie. Cinq trades profitables dans un sous-groupe doivent rester visiblement différents de 200 observations.
Méfie-toi des étiquettes comme « journée de tendance ». Une séance peut paraître évidemment directionnelle après la clôture. Un filtre d’entrée utilisable doit reposer sur les informations disponibles au moment de la décision. Sinon, il profite d’une connaissance du futur.
Chaque nouveau sous-groupe examiné offre aussi une occasion supplémentaire de découvrir un motif accidentel. Si les mardis matin ne semblent excellents qu’après avoir exploré toutes les heures et tous les jours, considère cette découverte comme une nouvelle hypothèse. Teste-la sur de nouvelles informations avant de la présenter comme une amélioration établie.
6 Trouver des motifs dans le bruit
À retenir
Sélectionner le meilleur résultat historique change sa signification. Conserve l’historique de recherche, y compris les versions qui ont échoué.
Imagine des élèves qui s’entraînent avec le corrigé. Une note parfaite à ces questions ne dit pas comment ils répondront à des questions nouvelles. Un problème semblable apparaît dans un backtest lorsque les paramètres sont ajustés à répétition pour correspondre aux mêmes résultats historiques.
C’est le surajustement, ou overfitting : adapter une méthode trop étroitement à un échantillon particulier, y compris à ses caractéristiques aléatoires. Les travaux de Bailey, Borwein, López de Prado et Zhu étudient comment tester de nombreuses configurations peut produire des performances historiques impressionnantes, même lorsque la découverte apparente ne se généralise pas. [6][7]
La recherche peut être manuelle. Changer la plage horaire, supprimer un mois difficile, essayer une autre distance de stop et changer d’instrument sont autant de choix supplémentaires. Tu n’as pas besoin d’un programme d’optimisation pour t’adapter au passé.
Pour rendre le problème visible, la figure 4 simule 100 méthodes sans avantage brut par construction. Chaque trade gagne ou perd indépendamment 1R avec la même probabilité. Un coût de 0,05R est ensuite déduit : toutes les méthodes ont donc une espérance nette de −0,05R par trade.
Après 200 trades, on sélectionne la méthode dont le résultat net cumulé est le plus élevé. On suit ensuite cette même méthode pendant 200 nouveaux trades simulés, sans changer la sélection.
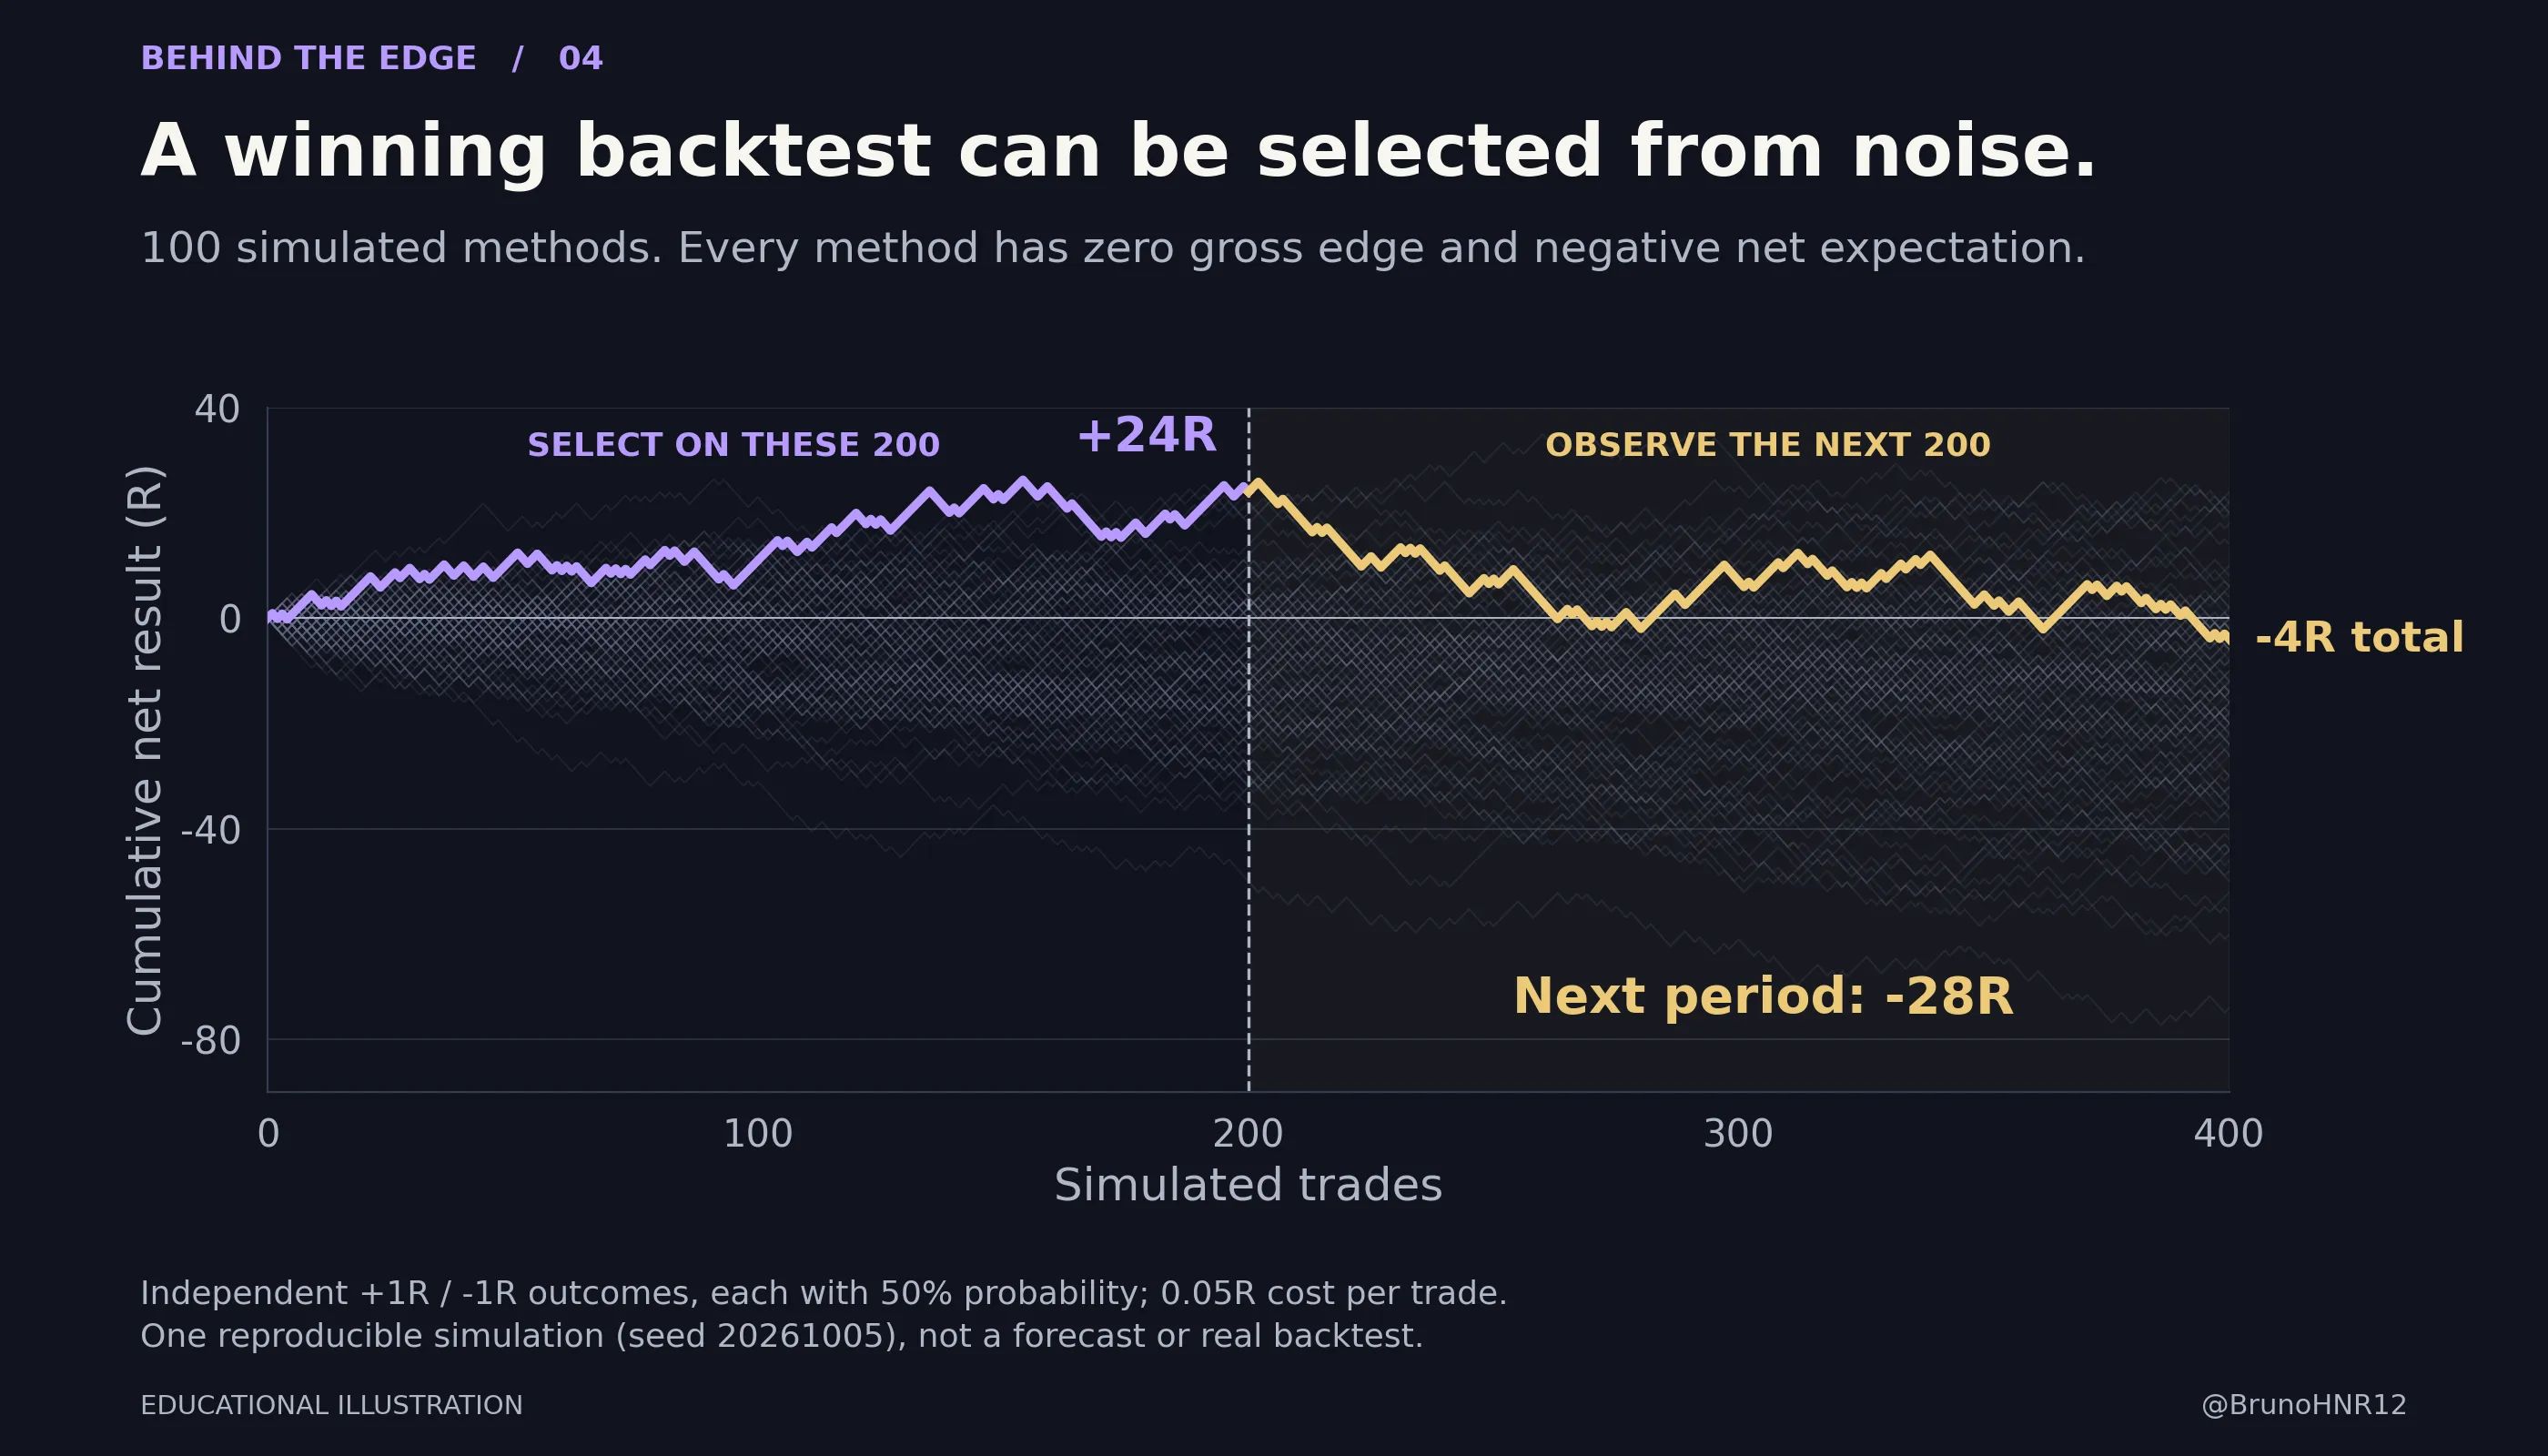
Dans cette simulation reproductible, la méthode sélectionnée gagne +24R pendant la période de sélection et perd 28R sur la suivante. Aucune méthode n’a reçu de véritable avantage. Le premier segment attrayant provient de la sélection d’une réalisation favorable du hasard.
Il s’agit d’une expérience générée, pas d’une prévision de la manière dont tous les backtests échouent. Une autre graine aléatoire pourrait produire un segment suivant profitable. Cette possibilité fait partie de la leçon : même de courts échantillons futurs peuvent être chanceux. Les variantes de stratégies réelles sont aussi souvent corrélées, contrairement aux méthodes volontairement indépendantes de ce modèle simplifié.
Pour la recherche, il faut donc enregistrer comment tu es arrivé au résultat. Garde un historique daté des versions, des paramètres essayés, des périodes examinées et des motifs de chaque changement. Une courbe choisie parmi 100 tentatives n’apporte pas le même poids de validation qu’une règle définie avant d’avoir observé le moindre résultat.
7 Vérifier si le backtest aurait pu se produire
À retenir
Des calculs corrects ne compensent ni des informations impossibles à connaître ni des exécutions irréalistes.
Les bougies historiques résument le mouvement du prix. Elles ne révèlent pas nécessairement l’ordre de chaque transaction à l’intérieur de la bougie.
Imagine une position acheteuse ouverte à 100 juste avant le début d’une bougie, avec un stop à 95 et un objectif à 105. La bougie suivante ouvre à 100, atteint un plus haut de 106 et un plus bas de 94, puis clôture à 102.
Si le prix atteint l’objectif en premier, la position sort en gain. S’il atteint le stop en premier, elle sort en perte. Les deux trajectoires peuvent produire exactement la même bougie terminée.
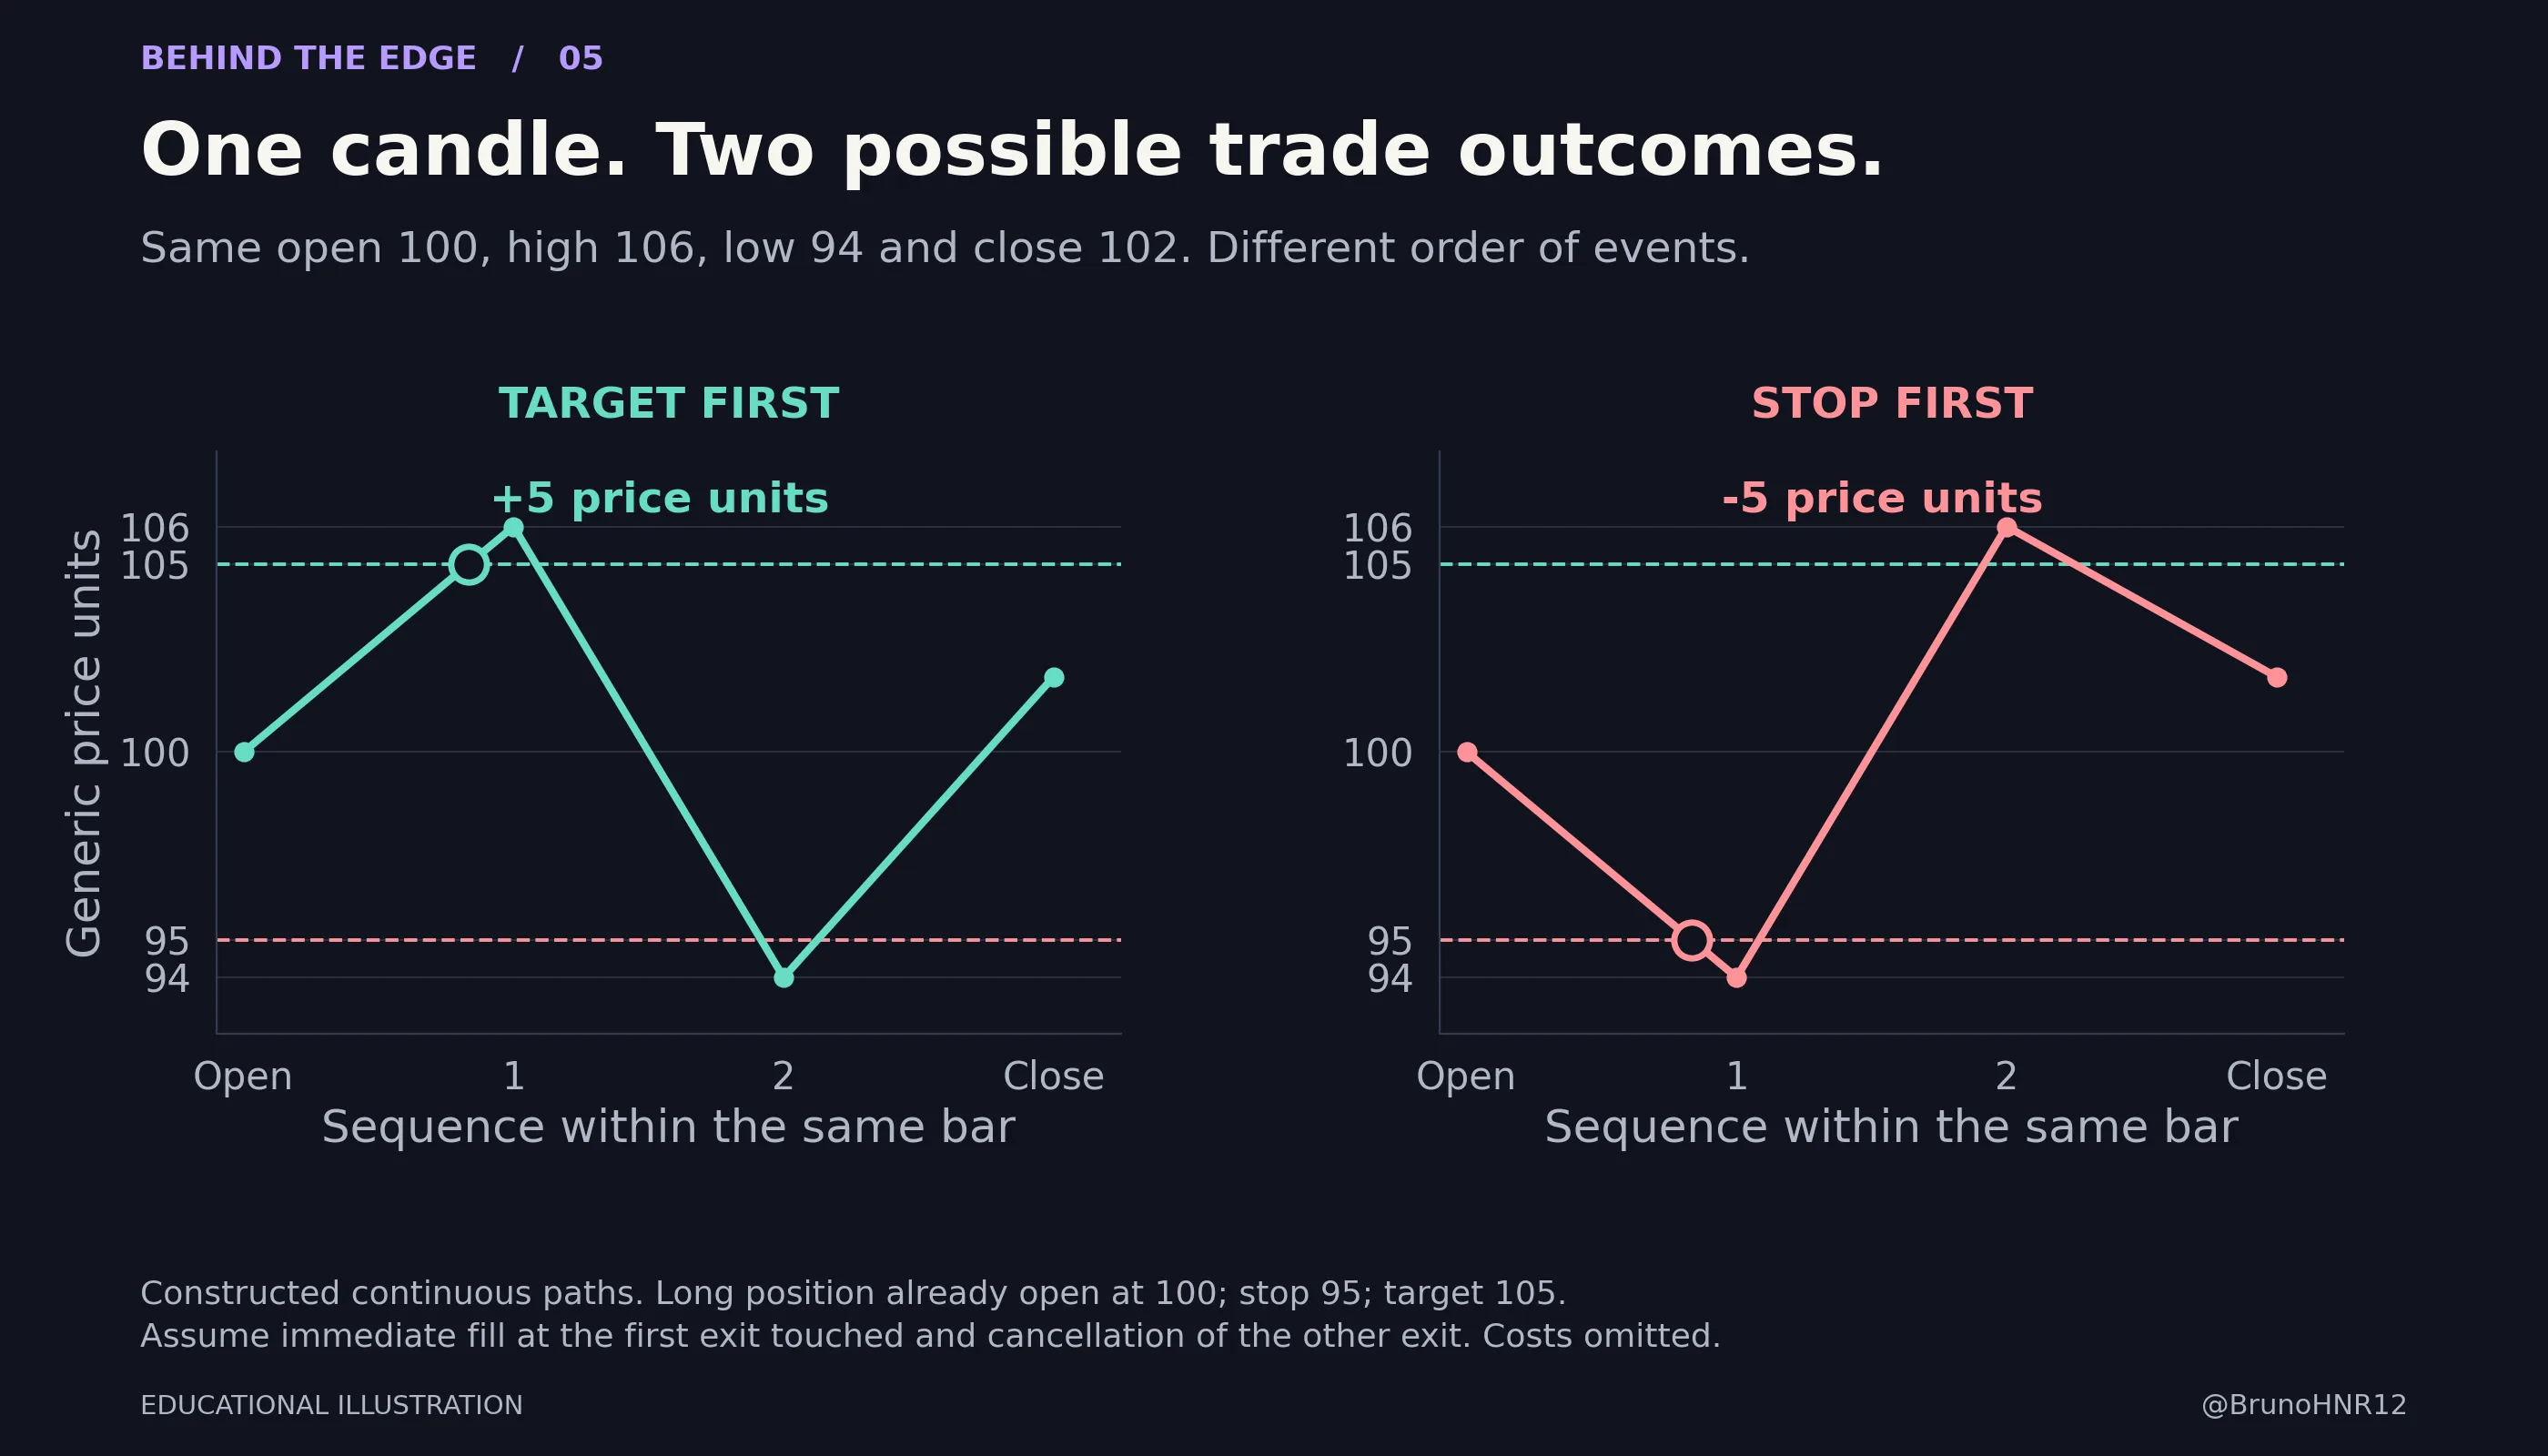
Le schéma suppose des trajectoires continues, une exécution immédiate au premier niveau de sortie et l’annulation de l’autre sortie. Il isole l’ordre des événements. Les exécutions réelles ajoutent d’autres incertitudes.
Un moteur de backtest doit résoudre ce problème d’une manière ou d’une autre. TradingView documente par exemple ses hypothèses par défaut sur la séquence à l’intérieur d’une bougie et l’utilisation de données d’unités de temps inférieures lorsqu’un historique plus détaillé est activé. Davantage de détail peut améliorer la séquence, mais cela reste une simulation. [8]
Pour un test manuel, signale les bougies ambiguës au lieu de choisir la sortie favorable. Examine des données plus fines lorsqu’elles sont disponibles, ou présente la plage de résultats selon des hypothèses explicites. Si le résultat passe de profitable à non profitable selon ce choix, l’ambiguïté est déterminante.
Vérifie ensuite le biais d’anticipation, ou lookahead bias : utiliser une information avant qu’elle ait été disponible. Acheter avant la clôture en se fondant sur cette clôture finale, ou exclure une séance perdante parce que tu sais déjà qu’elle a terminé en range, en sont des exemples. Les calculs historiques et en temps réel doivent respecter le même moment de disponibilité de l’information. [8]
Pour les futures, documente le contrat réel et la politique de rollover. Un graphique continu relie plusieurs échéances. L’ajustement rétrospectif peut déplacer les prix anciens pour tenir compte des écarts entre contrats. Sierra Chart explique ces ajustements dans sa documentation officielle. [9] Ne traite pas un niveau historique ajusté comme une cotation réellement exécutable sans vérifier sa construction.
Note également le fuseau horaire, les horaires de séance, les bougies manquantes et la granularité des données. Une stratégie fondée sur le range d’ouverture peut changer quand la définition de l’« ouverture » change. Le fait qu’un prix limite ait été touché ne démontre pas que ton ordre aurait été exécuté dans la file d’attente. Un test doit inclure une règle d’exécution défendable et une analyse de sensibilité à une exécution moins favorable.
La NFA cite le recul rétrospectif, la liquidité et le slippage parmi les limites de la performance hypothétique. Ses indications rappellent utilement qu’une simulation historique et le trading réel répondent à des questions différentes. [10]
8 Tester la fragilité du résultat
À retenir
De petits changements plausibles méritent d’être examinés avant qu’un seul paramétrage favorable ne devienne une source de confiance.
Supposons qu’un résultat semble excellent avec une fenêtre de référence de 15 minutes et un objectif de 2R. Que se passe-t-il avec des paramètres voisins ? Avec une exécution légèrement moins bonne ou si la meilleure séance est manquée ?
La figure 6 présente deux surfaces de performance délibérément construites. Chaque cellule représente un résultat net moyen hypothétique en R par trade pour une paire de paramètres. La surface de gauche reste positive autour des réglages voisins. Celle de droite contient un résultat exceptionnel entouré de résultats faibles.
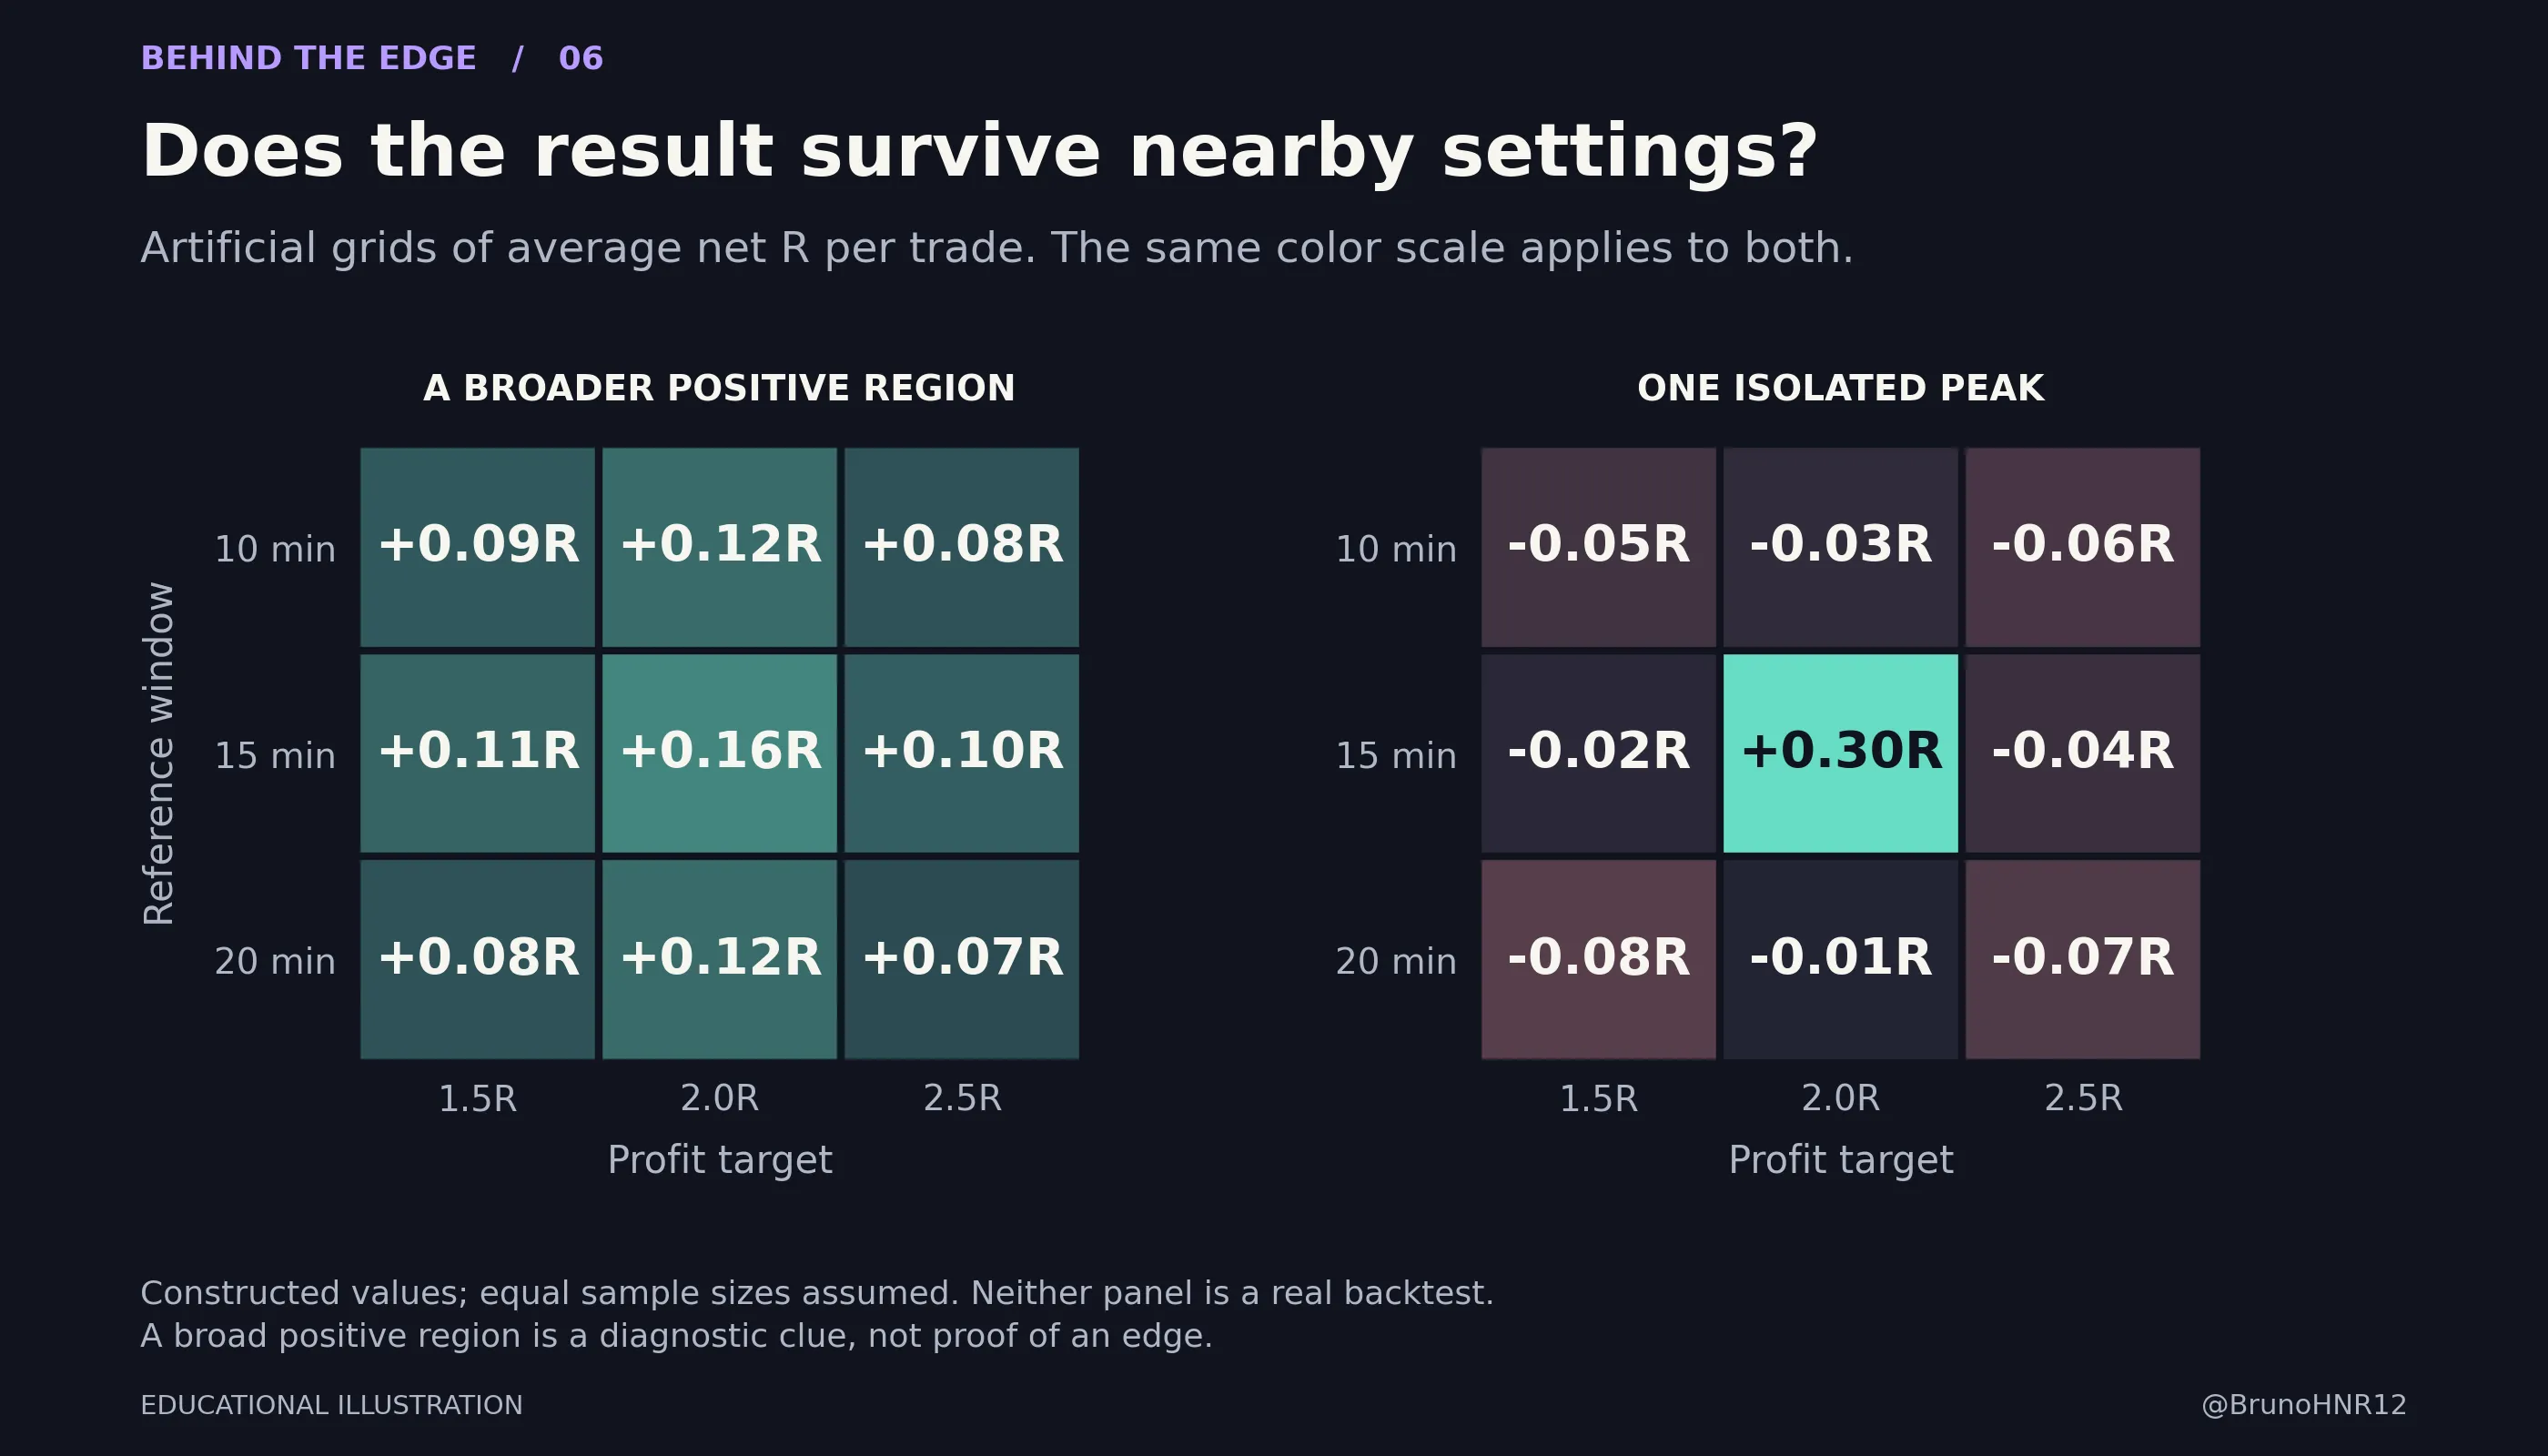
Une zone positive plus large donne une raison d’étudier la stabilité. Un pic isolé donne une raison d’étudier la fragilité. Aucun ne démontre un avantage, et certaines règles économiquement pertinentes peuvent comporter de véritables seuils. La grille est un outil de diagnostic, pas un certificat de validation.
Limite le nombre de variations et explique leur objectif. Explorer sans cesse de nouvelles grilles jusqu’à en trouver une attrayante recrée le problème de sélection décrit dans la section 6.
Parmi les vérifications utiles : une hypothèse de coûts plausiblement plus élevés, un léger délai d’exécution, des ordres non exécutés et un paramètre voisin modifié. Conserve le résultat d’origine à côté de chaque hypothèse modifiée. Si manquer quelques trades légitimes détruit le résultat, examine si ton emploi du temps et ta discipline permettent réellement de suivre la méthode.
Les tests de résistance doivent répondre à une préoccupation concrète. Inventer des centaines de scénarios arbitraires pour choisir ceux auxquels ta stratégie résiste n’apporte rien. Un historique de slippage extrême durant un événement précis constitue, par exemple, une meilleure raison de tester des exécutions dégradées que le désir de rendre un tableur plus rigoureux en apparence.
9 Construire un test qui préserve les informations nouvelles
À retenir
Décide des règles et du processus d’évaluation avant de voir les prochains résultats. Réutiliser un test pour améliorer la méthode consomme son indépendance.
Sépare le développement de l’évaluation dans le temps. Cela ne crée pas de certitude, mais facilite l’interprétation des éléments recueillis.
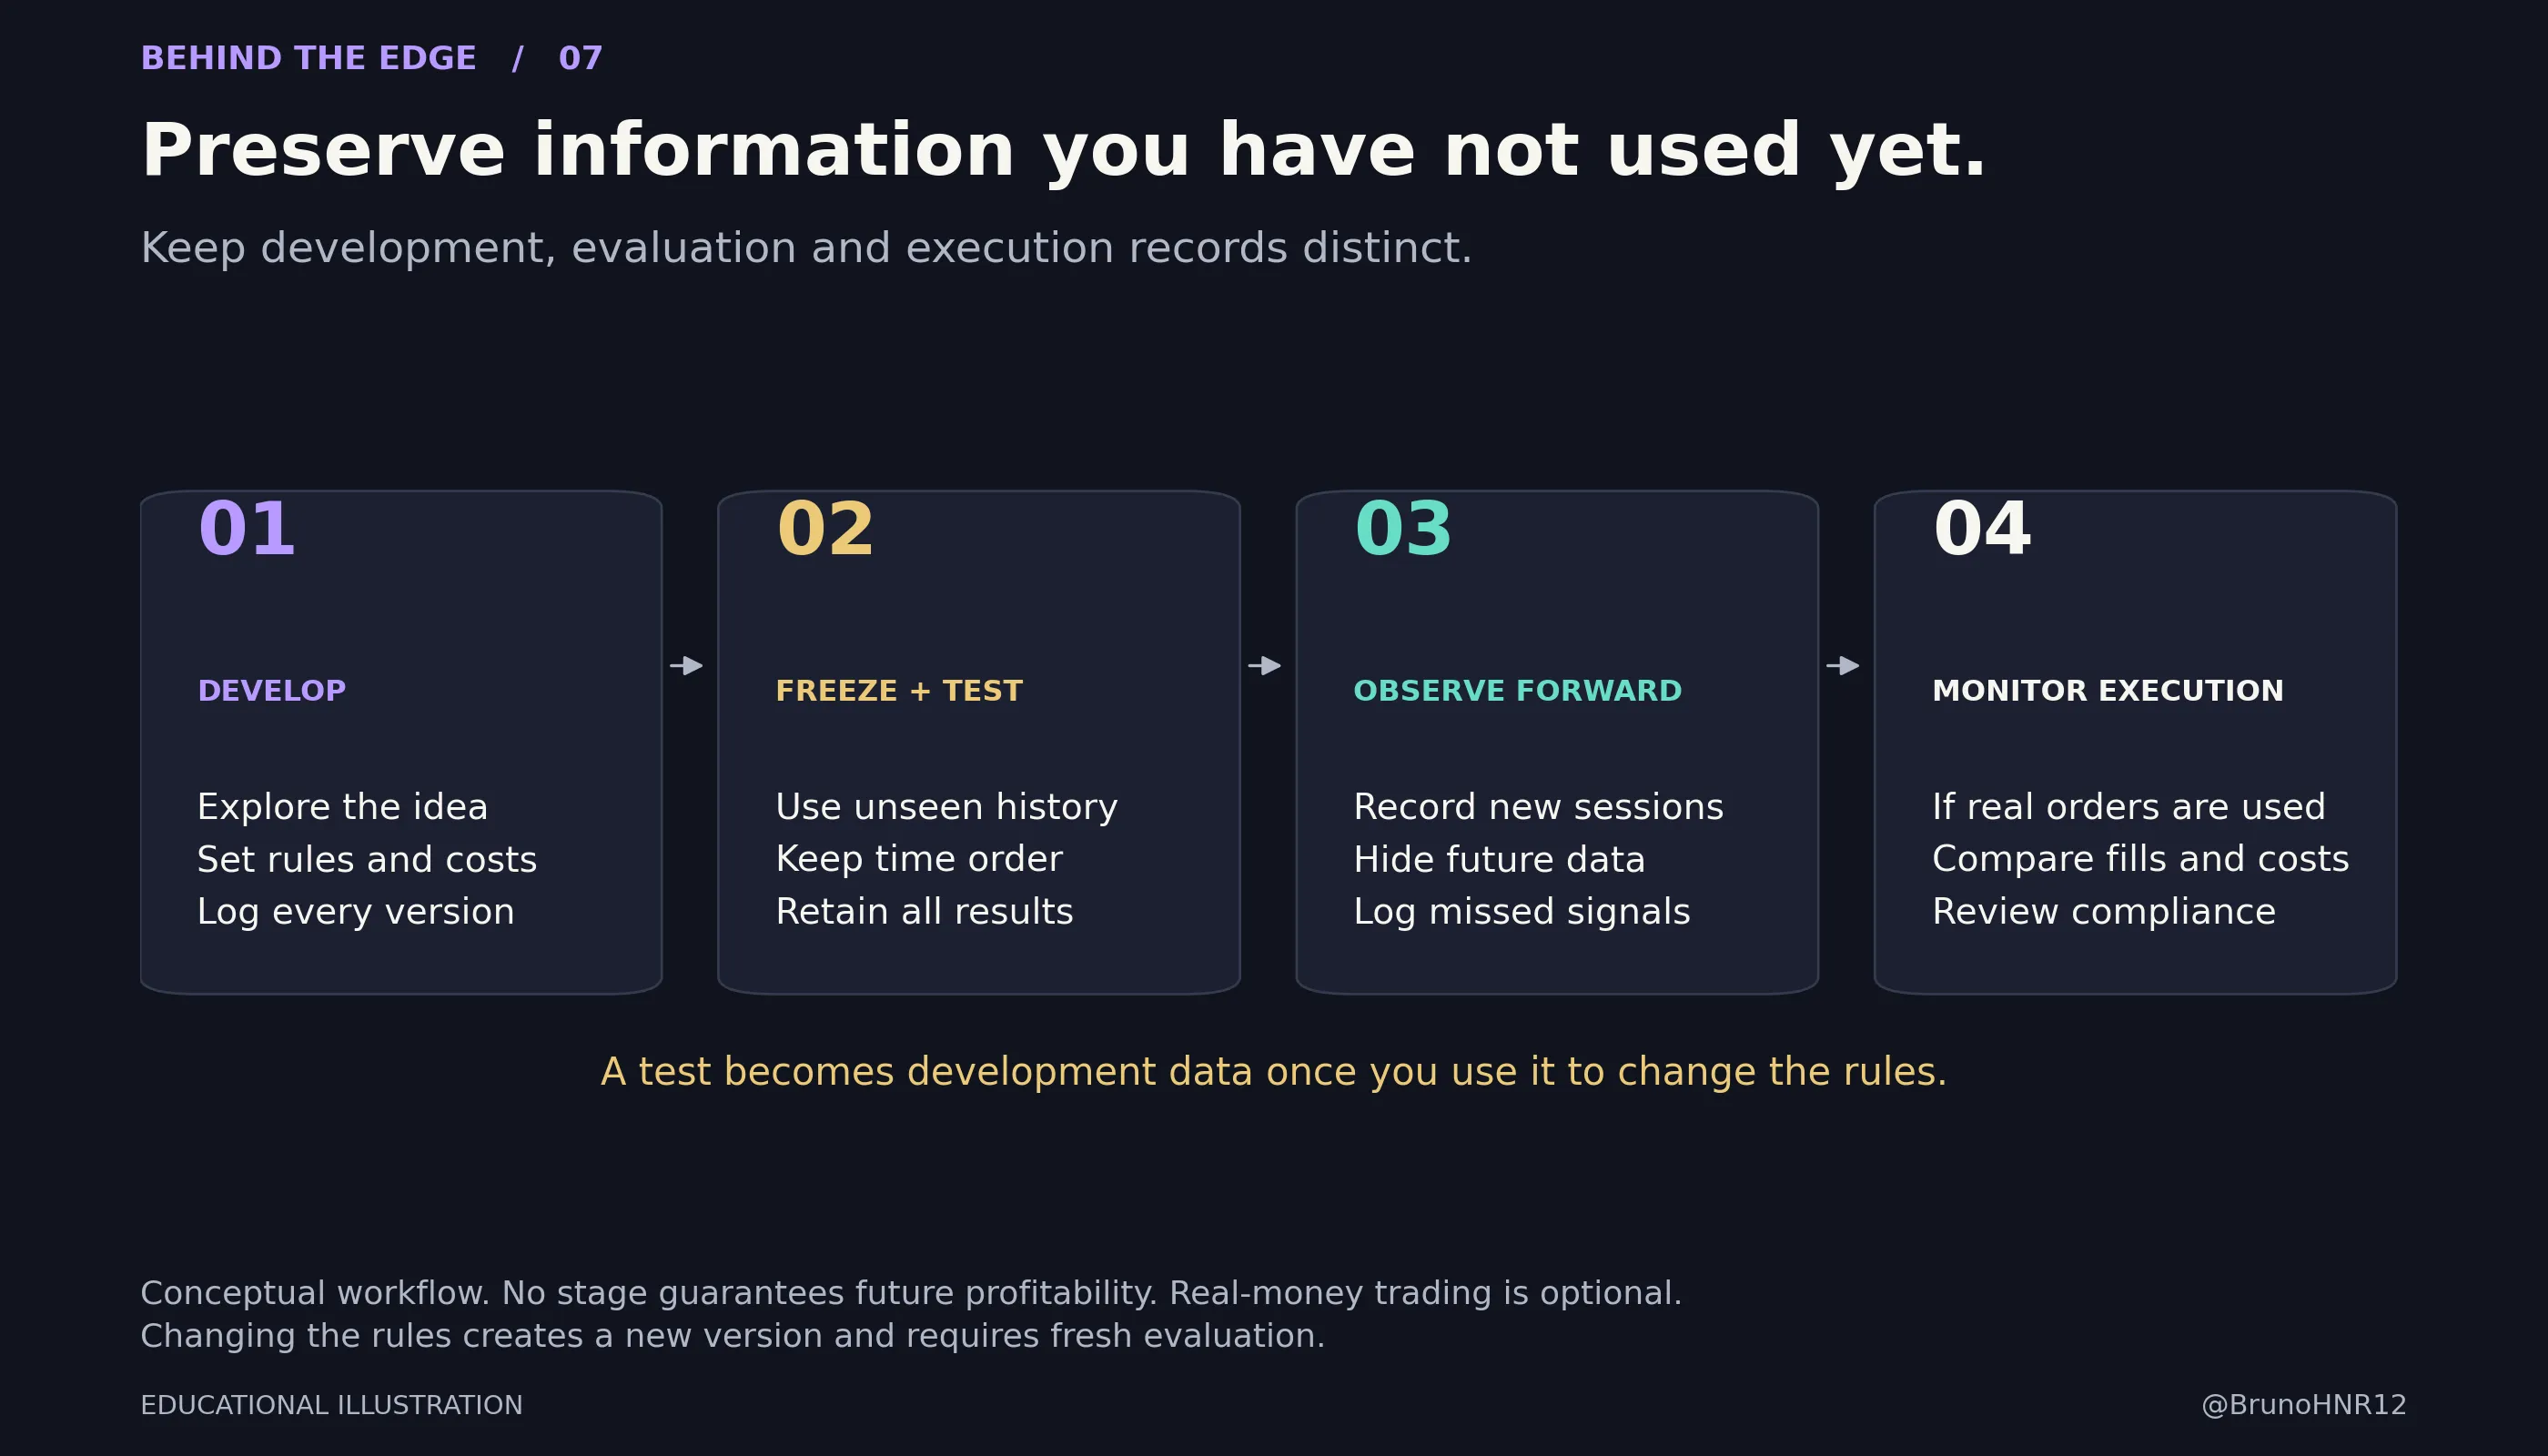
Développement. Explore une idée, définis les règles, corrige les erreurs et estime des coûts réalistes. Présente ces résultats comme des résultats de développement. Consigne les alternatives et les versions écartées.
Évaluation historique. Applique la version figée à une période ultérieure qui n’a pas servi à la concevoir. Définis à l’avance les dates et les critères de réussite ou d’échec. La séparation chronologique est utile pour une méthode destinée à fonctionner lors de séances futures, même si une période peut rester peu représentative.
Simulation prospective. Enregistre les décisions à mesure que de nouvelles données de marché arrivent, sans accès aux bougies futures. Conserve les occasions manquées, les signaux rejetés et les heures réelles de décision. Cela aide à tester si la méthode peut être reconnue et suivie sans recul rétrospectif.
Suivi de l’exécution. Si la méthode est un jour utilisée avec des ordres réels, compare les exécutions, les frais, les trades manqués et les comportements observés aux hypothèses. Sépare les relevés de simulation et d’exécution réelle. Cette étape apporte des éléments supplémentaires ; elle n’impose pas de risquer de l’argent pour terminer l’exercice.
La règle cruciale concerne ce qui se passe après un test décevant. Si tu examines les trades perdants et modifies la stratégie, tu développes légitimement une nouvelle version. La même période ne peut plus constituer, pour cette version, une source de validation restée intacte.
L’étiquette « hors échantillon », ou out-of-sample, ne suffit donc pas. Bailey et ses collègues discutent des limites des simples jeux de données réservés, notamment la sélection parmi de nombreuses tentatives et la difficulté de maintenir une véritable séparation. Une validation plus avancée exige de considérer l’ensemble du processus de recherche. [7]
Pour quelqu’un qui débute dans cette démarche, l’amélioration pratique est modeste mais précieuse : écrire le plan, figer une version, préserver la chronologie, consigner chaque variante essayée et laisser s’accumuler des séances réellement nouvelles.
Fixe à l’avance les dates de revue et un nombre minimal d’observations, au lieu d’arrêter le test dès son premier sommet attrayant. Si tu utilises une significativité statistique formelle, les vérifications répétées exigent un dispositif adapté de tests séquentiels ; on ne peut pas simplement réutiliser des seuils ordinaires pour échantillon fixe jusqu’à ce qu’ils approuvent la stratégie. Les recherches sur les expériences surveillées en continu expliquent cette distinction. [11]
Une limite de sécurité opérationnelle est différente. Une panne de données, un problème d’acheminement des ordres ou une limite de perte prédéfinie peuvent justifier l’arrêt immédiat de l’activité. Consigne l’arrêt et conserve le test incomplet. Ne le requalifie pas en réussite achevée et ne le cache pas dans l’historique de recherche.
10 Séparer la méthode de ton exécution
À retenir
Conserve deux suivis : ce qui s’est passé financièrement et le respect du processus défini.
Considère quatre trades. Le premier suit le plan et gagne. Le deuxième suit le plan et perd. Le troisième enfreint les règles et gagne. Le quatrième enfreint les règles et perd.
Le relevé du compte les classe par résultat financier. Une revue utile les classe aussi selon le processus.
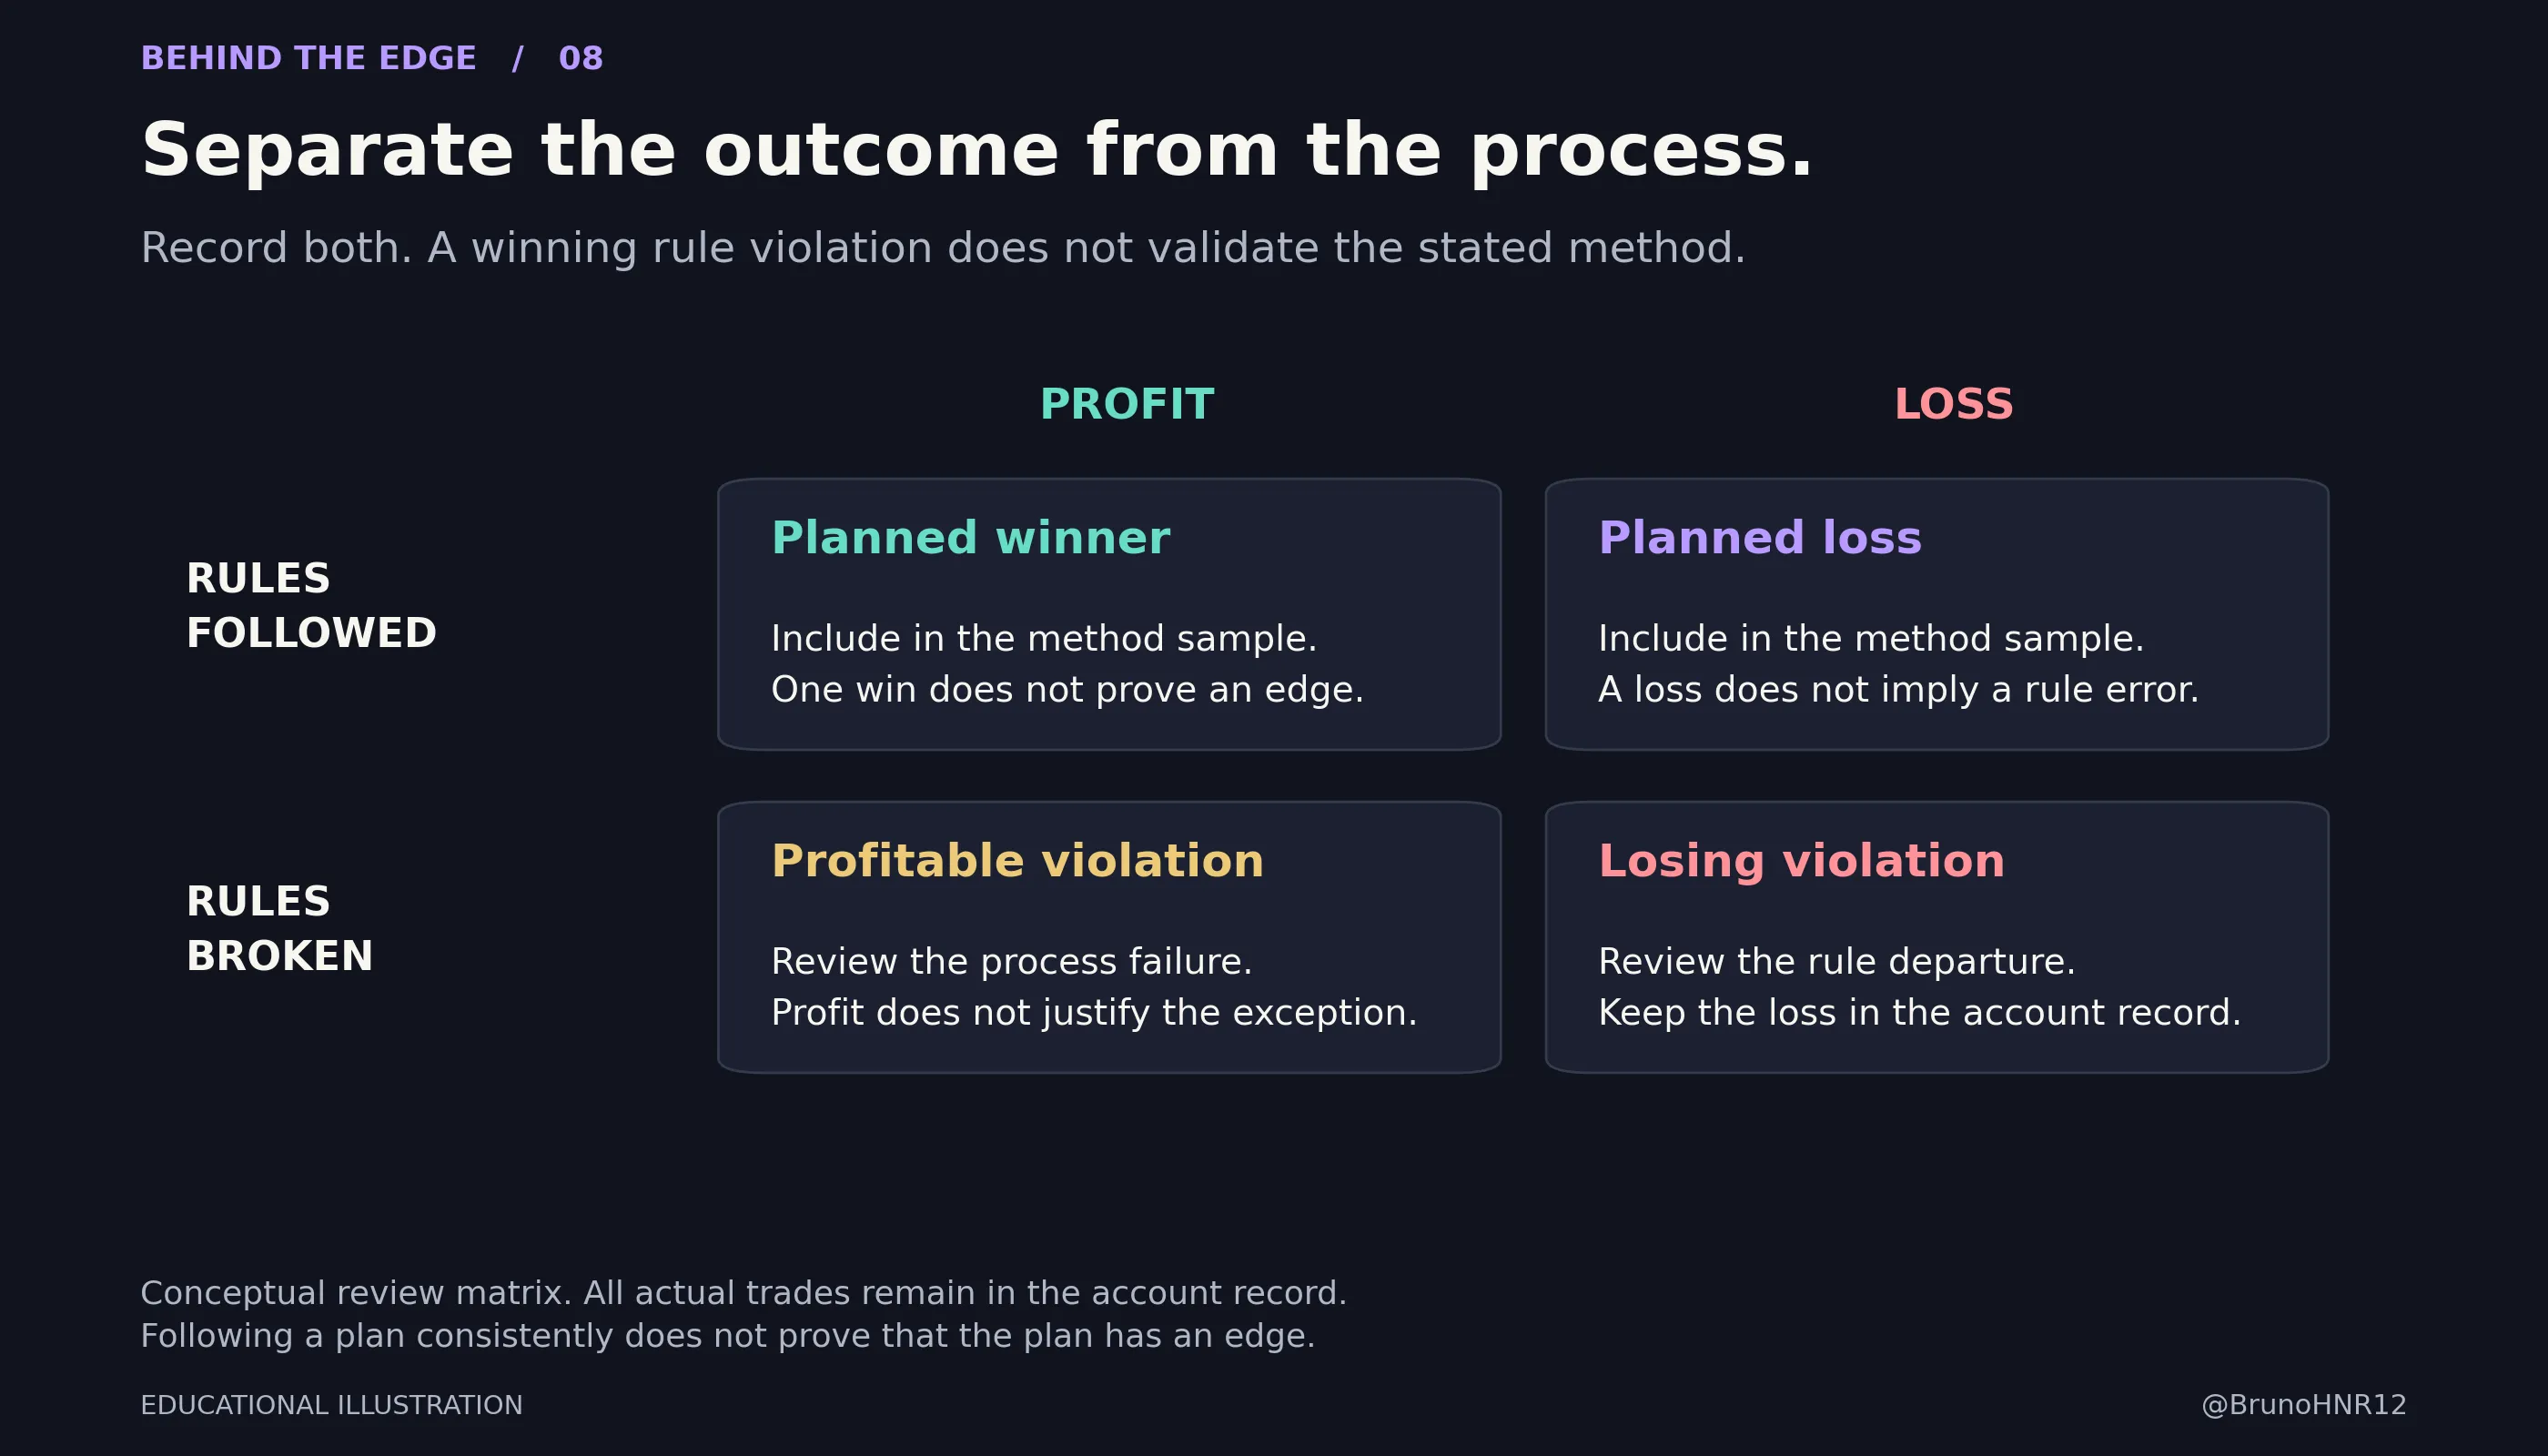
Une perte conforme fait partie des éléments d’évaluation de la méthode. La supprimer parce que le trade « aurait dû fonctionner » déforme l’échantillon. Une violation profitable fait partie du résultat réel du compte, mais elle ne soutient pas la performance des règles que tu prétends tester.
Le respect des règles ne prouve à lui seul ni un bon jugement ni une méthode rentable. Un trader peut exécuter parfaitement un système non rentable. Les deux suivis permettent d’identifier la question à traiter : les règles manquent-elles de validation, ou le comportement réalisé s’est-il écarté des règles ?
Un journal pratique doit conserver la version du setup, l’horodatage et le contrat ; les informations et le motif d’entrée ; les prix prévus et réels ; le R initial et les changements de taille ; les frais explicites ; les résultats nets en R et en dollars ; le statut de conformité ; et les captures prises au moment de la décision. Ajoute une raison précise pour les signaux admissibles ignorés et les trades pris hors des règles.
Compare ensuite le modèle et l’exécution avec une définition cohérente. Par exemple, un modèle prospectif peut enregistrer +12R sur ses occasions admissibles, tandis que le compte réel enregistre +3R. Cet écart invite à rapprocher les signaux manqués, les trades supplémentaires, les sorties différentes et les écarts d’exécution. Il ne prouve pas automatiquement un manque de discipline : les hypothèses d’exécution du modèle peuvent aussi être erronées.
Garde les deux totaux. Présenter uniquement les trades réels conformes peut aider à diagnostiquer une méthode, mais ne décrit pas toute l’expérience du compte. Présenter uniquement le modèle idéal masque la capacité du trader à l’exécuter réellement.
11 Décider ce que les éléments permettent de conclure aujourd’hui
À retenir
Une revue utile se termine par un statut précis et une raison. Elle n’a pas besoin de se terminer par une déclaration de certitude.
Prépare une fiche de revue concise. Indique la version et les règles de la stratégie, les dates de test, le nombre de trades et de séances, la source des données, le modèle de coûts, les résultats nets, la distribution des résultats, le drawdown, la concentration dans les gros gagnants et les écarts entre modèle et exécution. Précise si chaque période a servi au développement, à une évaluation historique restée intacte ou à une observation prospective.
Utilise quelques statuts clairs :
- Non évaluable : les règles, les données ou les hypothèses d’exécution sont trop floues pour interpréter le résultat. Corrige les relevés avant de juger la méthode.
- Non étayé par ce test : le résultat ne remplit pas les critères choisis à l’avance. Conserve-le et explique ce qui a échoué.
- Prometteur, mais incertain : les observations nettes sont encourageantes, mais l’échantillon, les conditions couvertes ou la sensibilité laissent des questions importantes ouvertes.
- Étayé dans le périmètre testé : plusieurs vérifications pertinentes et de nouvelles observations soutiennent la version actuelle. Précise les conditions et continue le suivi ; ce n’est pas une garantie permanente.
Quels critères choisir ? Ils dépendent de l’affirmation. Un test de faisabilité simple peut examiner si des coûts prudents effacent le résultat moyen, si la méthode repose sur des exécutions impossibles et si une période ultérieure contredit le résultat du développement. Affirmer formellement une espérance nette positive exige une analyse de l’incertitude adaptée aux observations, à leur dépendance et au processus de sélection.
Ne remplace pas ce travail par un seuil universel de profit factor, un taux de réussite imposé ou un nombre fixe de trades. Le profit factor divise, par exemple, le total des gains par la valeur absolue du total des pertes. Il décrit un échantillon, peut être gonflé par quelques trades et devient instable lorsque les pertes sont très peu nombreuses.
Examine également les changements de conditions de marché et d’exécution. Si les coûts augmentent ou si le setup d’origine devient rare, la question pertinente est de savoir si la méthode actuelle correspond encore à son périmètre annoncé. Redéfinir discrètement le setup pour protéger un historique favorable empêche cette comparaison.
La même discipline s’applique aux résultats d’autrui. Demande les règles, les coûts nets, les dates de l’échantillon, le caractère réel ou hypothétique des résultats, les versions essayées et les éléments réellement nouveaux. Une capture impressionnante laisse la plupart de ces questions sans réponse.
Une dernière vérification avant de croire à la courbe
Peux-tu expliquer quelle version a produit le résultat, comment les décisions ont été prises sans information future et combien il restait après les coûts ?
Peux-tu identifier les conditions qui ont le plus contribué, les hypothèses dont dépend le résultat et les éléments recueillis après avoir figé les règles ?
Peux-tu distinguer une méthode faible d’une méthode que tu n’as pas exécutée comme prévu ?
Ces réponses rendent une période profitable plus informative. Elles rendent aussi une période perdante plus utile. L’objectif est de construire une confiance qui reste proportionnée aux éléments disponibles.
Quelle partie de ta stratégie as-tu réellement testée, et quelle partie repose encore sur ta confiance ?
Sources et méthodologie des graphiques
Sources vérifiées le 5 octobre 2026. Les recherches fondatrices sont identifiées par leur date de publication d’origine. Les exemples sont des constructions pédagogiques originales, pas des reproductions de la performance d’une source citée.
[1] CME Group. The Mathematics of Trading Success. Espérance mathématique et relation entre fréquence des résultats et montant des gains ou pertes. Consulter la source ↗
[2] CME Group. Micro E-mini Nasdaq-100 Index Futures Contract Specifications. 2 $ par point d’indice et un incrément minimal de 0,25 point. Consulter la source ↗
[3] NIST/SEMATECH e-Handbook of Statistical Methods. Confidence intervals for a binomial proportion. Méthode utilisée pour la figure 2. Consulter la source ↗
[4] NIST/SEMATECH e-Handbook of Statistical Methods. What are confidence intervals. Interprétation de la couverture lors d’échantillonnages répétés. Consulter la source ↗
[5] NIST/SEMATECH e-Handbook of Statistical Methods. Autocorrelation Plot. Dépendance et hypothèses des formules statistiques courantes. Consulter la source ↗
[6] Bailey, Borwein, López de Prado et Zhu. Pseudo-Mathematics and Financial Charlatanism: The Effects of Backtest Overfitting on Out-of-Sample Performance. 2014. Consulter la source ↗
[7] Bailey, Borwein, López de Prado et Zhu. The Probability of Backtest Overfitting. Manuscrit des auteurs révisé en février 2015. Consulter la source ↗
[8] TradingView. Documentation Pine Script, Strategies. Émulateur de broker, détail historique, biais d’anticipation et tests de stratégies. Le fonctionnement propre à la plateforme doit être revérifié lors de l’implémentation d’un test. Consulter la source ↗
[9] Sierra Chart. Continuous Futures Contract Charts. Construction et interprétation des prix historiques ajustés rétrospectivement. Consulter la source ↗
[10] National Futures Association. Interpretive Notice 9025. Limites de la performance hypothétique, notamment recul rétrospectif, liquidité et slippage. Consulter la source ↗
[11] Johari, Koomen, Pekelis et Walsh. Always Valid Inference: Continuous Monitoring of A/B Tests. Publication en ligne en 2021 ; Operations Research 70(3), 2022. Fondements statistiques de la surveillance répétée, pas une étude de validation du trading sur futures. Consulter la source ↗
La figure 1 utilise un ensemble construit de 54 résultats à +1R et de 46 résultats à −1R, mélangés avec NumPy PCG64 et la graine 20261006. Un coût fixe de 0,10R est déduit par trade terminé. Il n’y a ni capitalisation ni changement de taille de position.
La figure 2 utilise des intervalles bilatéraux de Wilson avec z = 1,959963984540054 et les décomptes 12/20, 60/100 et 300/500. Le modèle à probabilité constante et résultats indépendants illustre l’incertitude d’échantillonnage ; il ne modélise pas une performance de trading réelle.
La figure 3 est un exemple construit de contributions : +20R sur trois trades et −5R sur les 97 autres, déjà nets des coûts supposés. Les figures 5 et 6 sont des trajectoires et des paramètres construits, pas des observations historiques.
La figure 4 utilise NumPy PCG64 avec la graine 20261005. Un tableau de 100 × 400 résultats indépendants est tiré dans {−1R, +1R} avec la même probabilité ; 0,05R est déduit par trade. La méthode ayant le résultat net cumulé le plus élevé au trade 200 est sélectionnée, les égalités étant départagées par la première position dans le tableau. Ses 200 résultats suivants ne sont pas utilisés pour la sélection. Les courbes montrent des R cumulés sans capitalisation. La simulation illustre le biais de sélection ; elle ne reproduit pas l’estimateur formel PBO de la référence 7.
Les figures 7 et 8 sont des schémas conceptuels. Tous les graphiques utilisent les calculs ou constructions originaux décrits ci-dessus. Les fichiers graphiques et le script de reproduction qui accompagnent l’article conservent ces hypothèses.
Transformer tes observations en décisions plus claires.
Tu connais tes règles, mais tu peines à les suivre en séance ? Le coaching individuel travaille ta performance, tes décisions et les blocages que tu rencontres. Séances en français ou en anglais ; l’anglais n’est pas ma langue maternelle.